Режимы усиления: Swift и Express
Когда файлы не содержат дополнительной информации о профилировании кейсов, n-Infinite предлагает два режима, предназначенных для увеличения числа кейсов с использованием только надежных обучающих профилей или демографических данных.
Когда загруженный файл соответствует требованиям — каждая строка заполнена — на этапе настройки автоматически предлагается режим усиления (вы всегда можете продолжить в стандартном режиме):
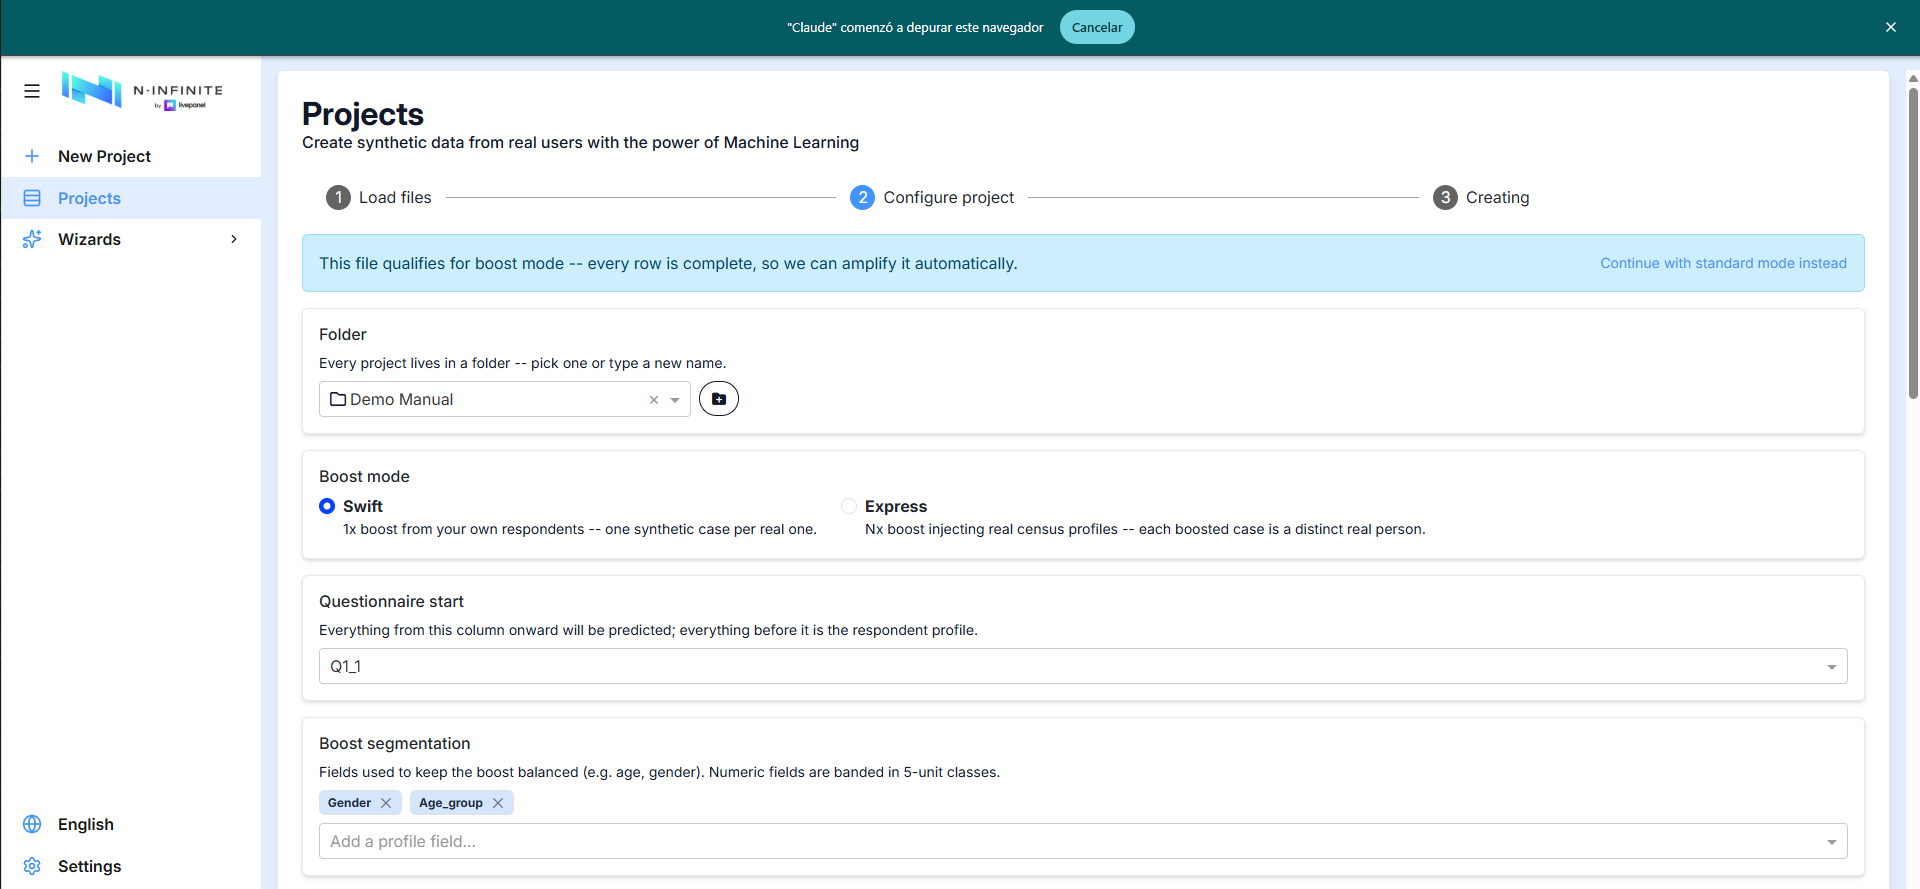
- Swift — усиление 1× на основе ваших собственных респондентов: один синтетический кейс на каждый реальный.
- Express — усиление N× с внедрением реальных профилей переписи: каждый усиленный кейс представляет собой отдельного реального человека. Требует наличия стран переписи, зарегистрированных для вашей организации (обратитесь к администратору).
Режим Swift
Swift обеспечивает усиление до 100% кейсов (обычно около 50%) с высококачественным исходным профилированием, дублируя это профилирование и повторно прогнозируя эти кейсы. Рекомендуется для B2B-проектов с дефицитом профилей для прогнозирования.
Поскольку обучение ML не является абсолютно точным для каждого кейса — в выборке обучающих и валидационных кейсов присутствует некоторая случайность — Swift вносит незначительные вариации, которые добавляют разнообразие, сохраняя при этом распределение каждой квоты.
Ключевым выбором является questionnaire start: все, начиная с этой колонки, прогнозируется; все, что до нее, является профилем респондента.
Сегментация усиления и сетка усиления
Выберите поля, которые поддерживают сбалансированное усиление (например, пол, возрастная группа — числовые поля автоматически группируются). Затем boost grid показывает каждую комбинацию сегментов с ее полевыми кейсами и ползунок для установки количества синтетических кейсов, которые нужно добавить в каждую ячейку, а также текущую общую сумму:
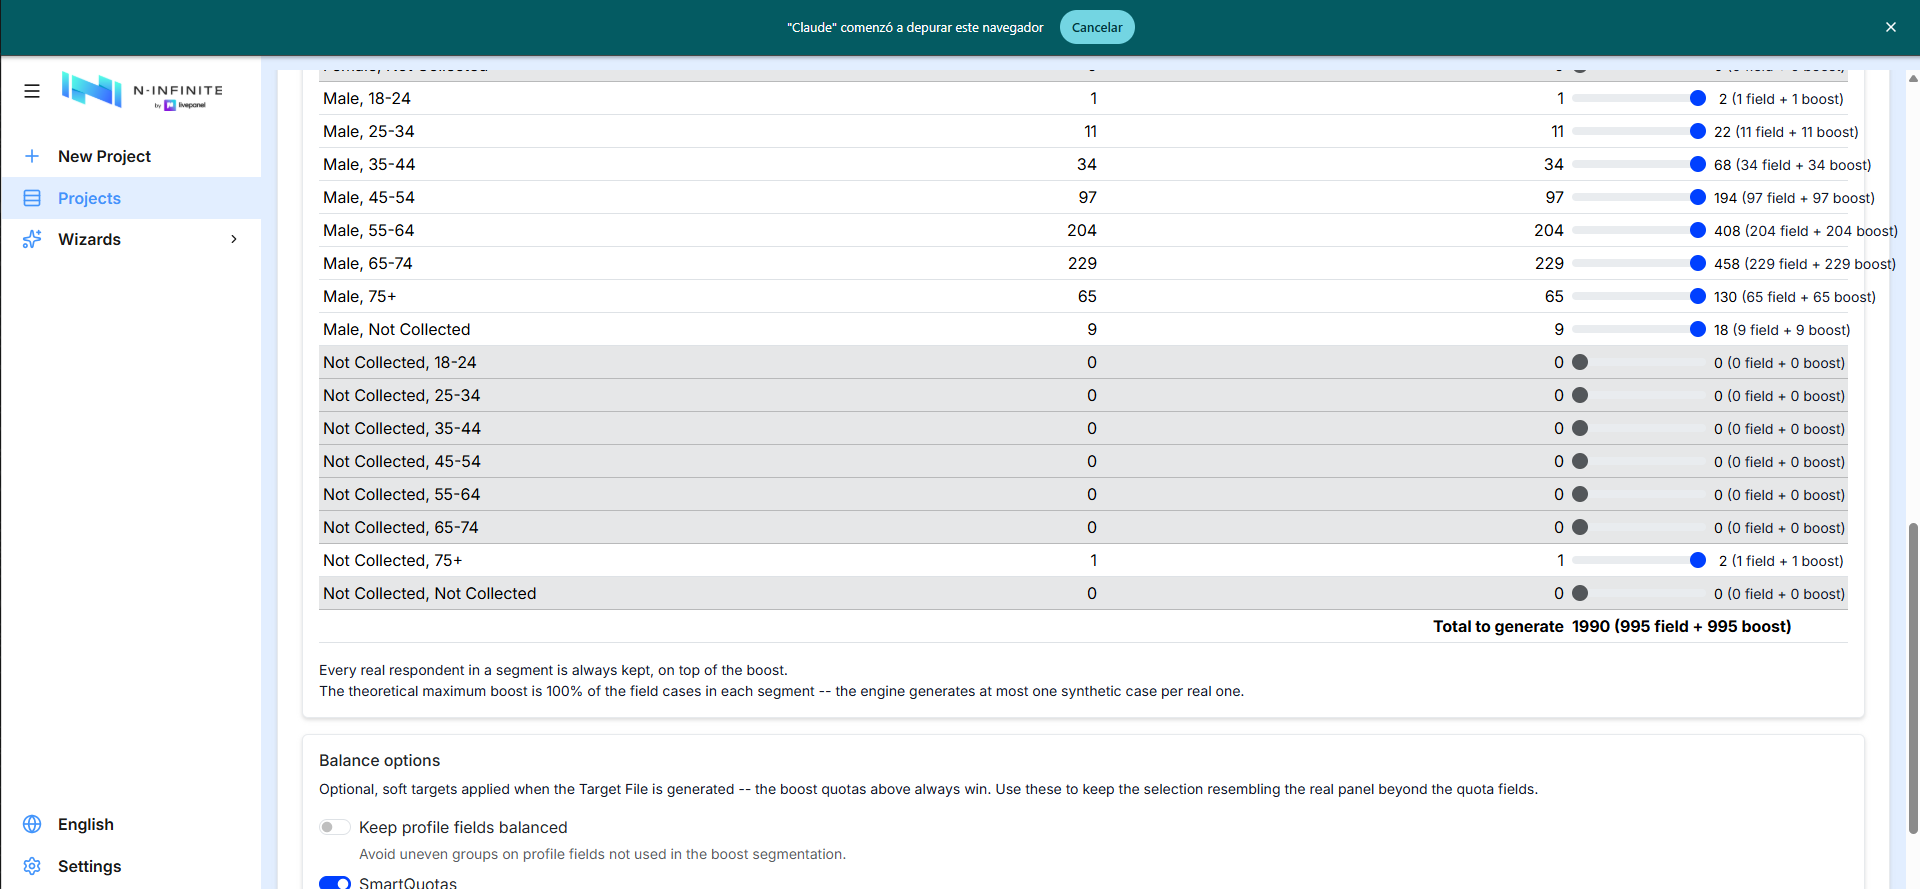
Два правила, которые следует помнить:
- Каждый реальный респондент в сегменте всегда сохраняется, помимо усиления.
- Теоретический максимальный коэффициент усиления составляет 100% от полевых кейсов в каждом сегменте — движок генерирует не более одного синтетического кейса на каждый реальный.
Параметры баланса и SmartQuotas
Дополнительные soft targets применяются при генерации целевого файла — квоты усиления, указанные выше, всегда имеют приоритет:
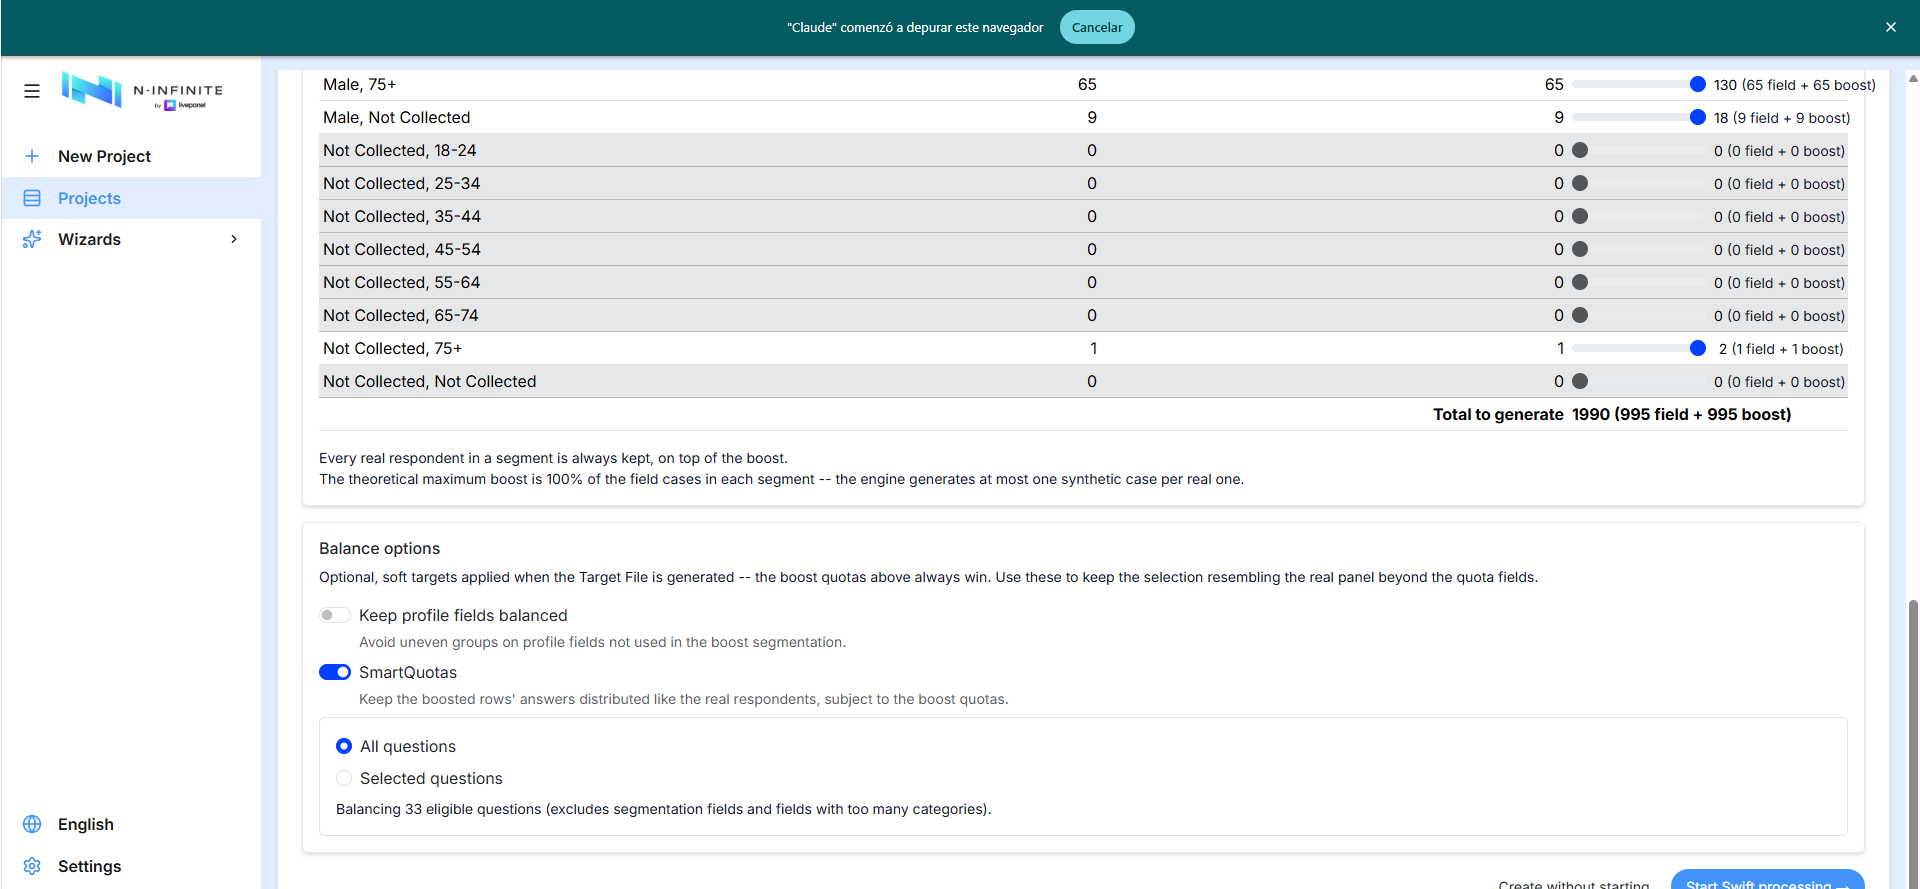
- Keep profile fields balanced — позволяет избежать несбалансированных групп по полям профиля, не используемым в сегментации усиления.
- SmartQuotas — сохраняет распределение answers усиленных строк аналогично реальным респондентам, с учетом квот усиления. Балансировка по all questions или выбор key columns, где пропорции критичны (поля сегментации и поля со слишком большим количеством категорий исключаются автоматически).
Наконец, Start Swift processing немедленно запускает усиление, или Create without starting оставляет проект в состоянии Created для последующей работы.
Выходные данные усиления
Завершенный проект усиления добавляет специальные загрузки в верхней части меню Download Merged — Target File (усиленный результат) в Excel или SPSS:
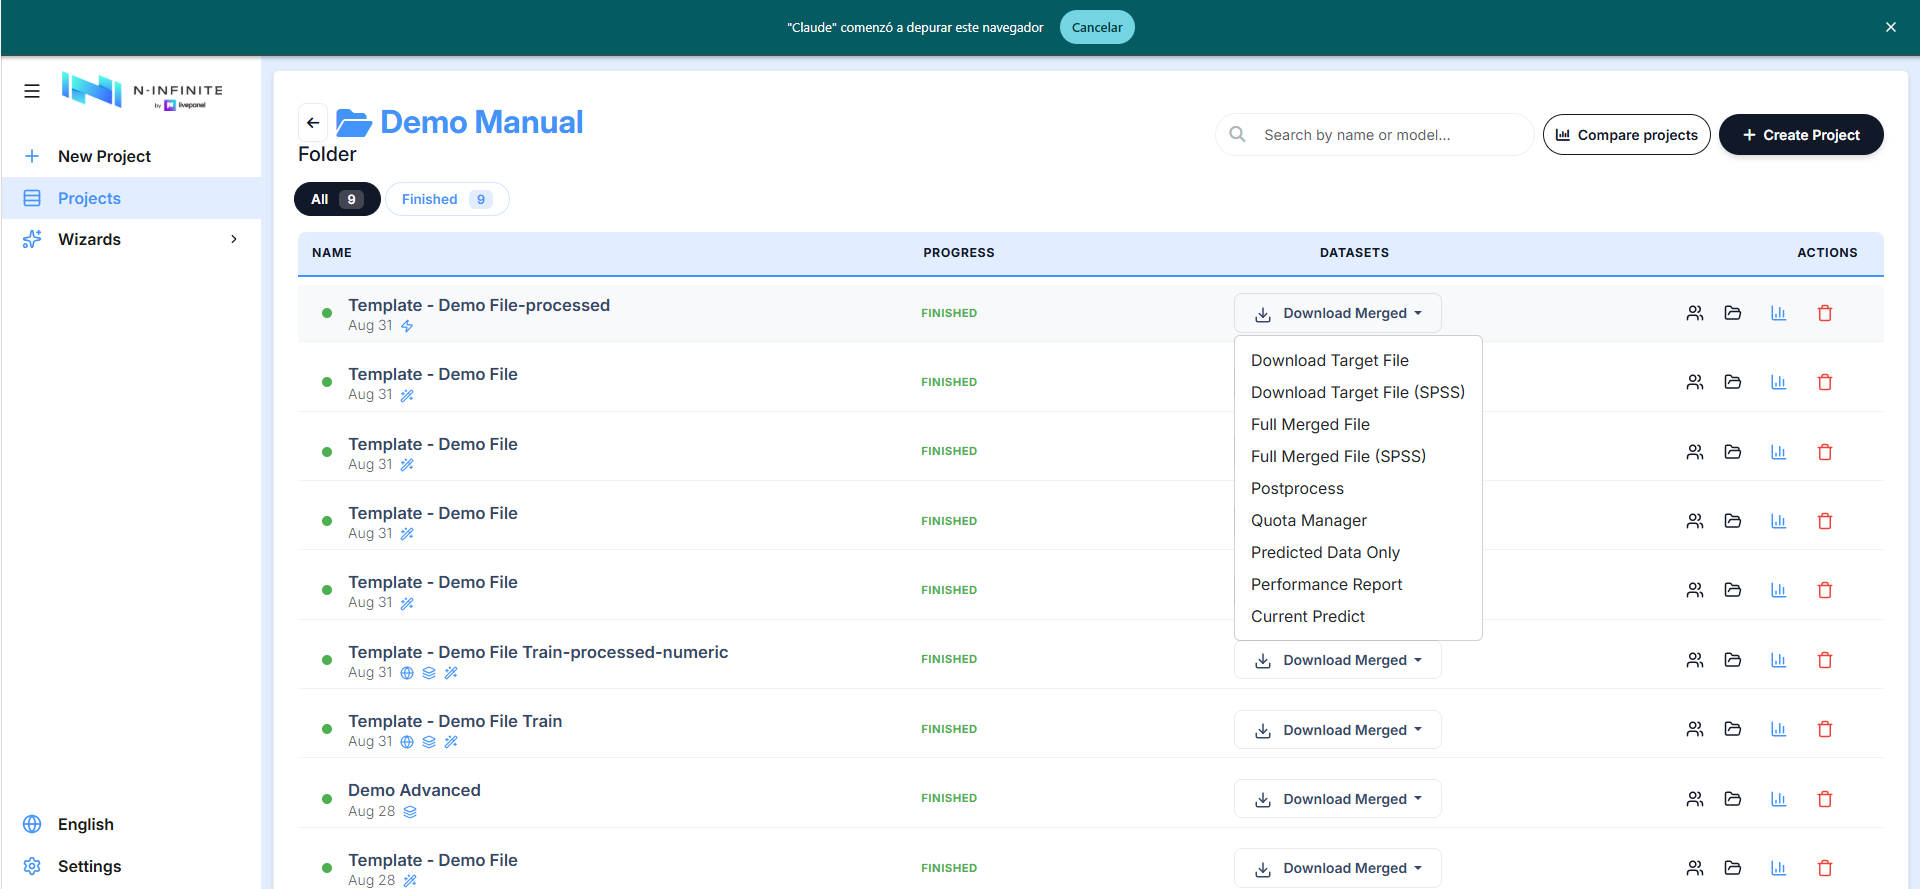
Режим Express
Express ориентирован на большие усиления и B2C-проекты. В отличие от Swift, который повторно использует собственное профилирование каждого кейса, Express внедряет отдельный реальный профиль переписи в каждый усиленный кейс, так что каждый синтетический респондент моделируется на основе другого реального человека. Рекомендуется постобработка весами.
Note
Для Express требуются страны переписи, зарегистрированные для вашей организации. Если опция отключена с сообщением "No census countries registered", свяжитесь с командой n-Infinite.
Выберите Express в блоке Boost mode:
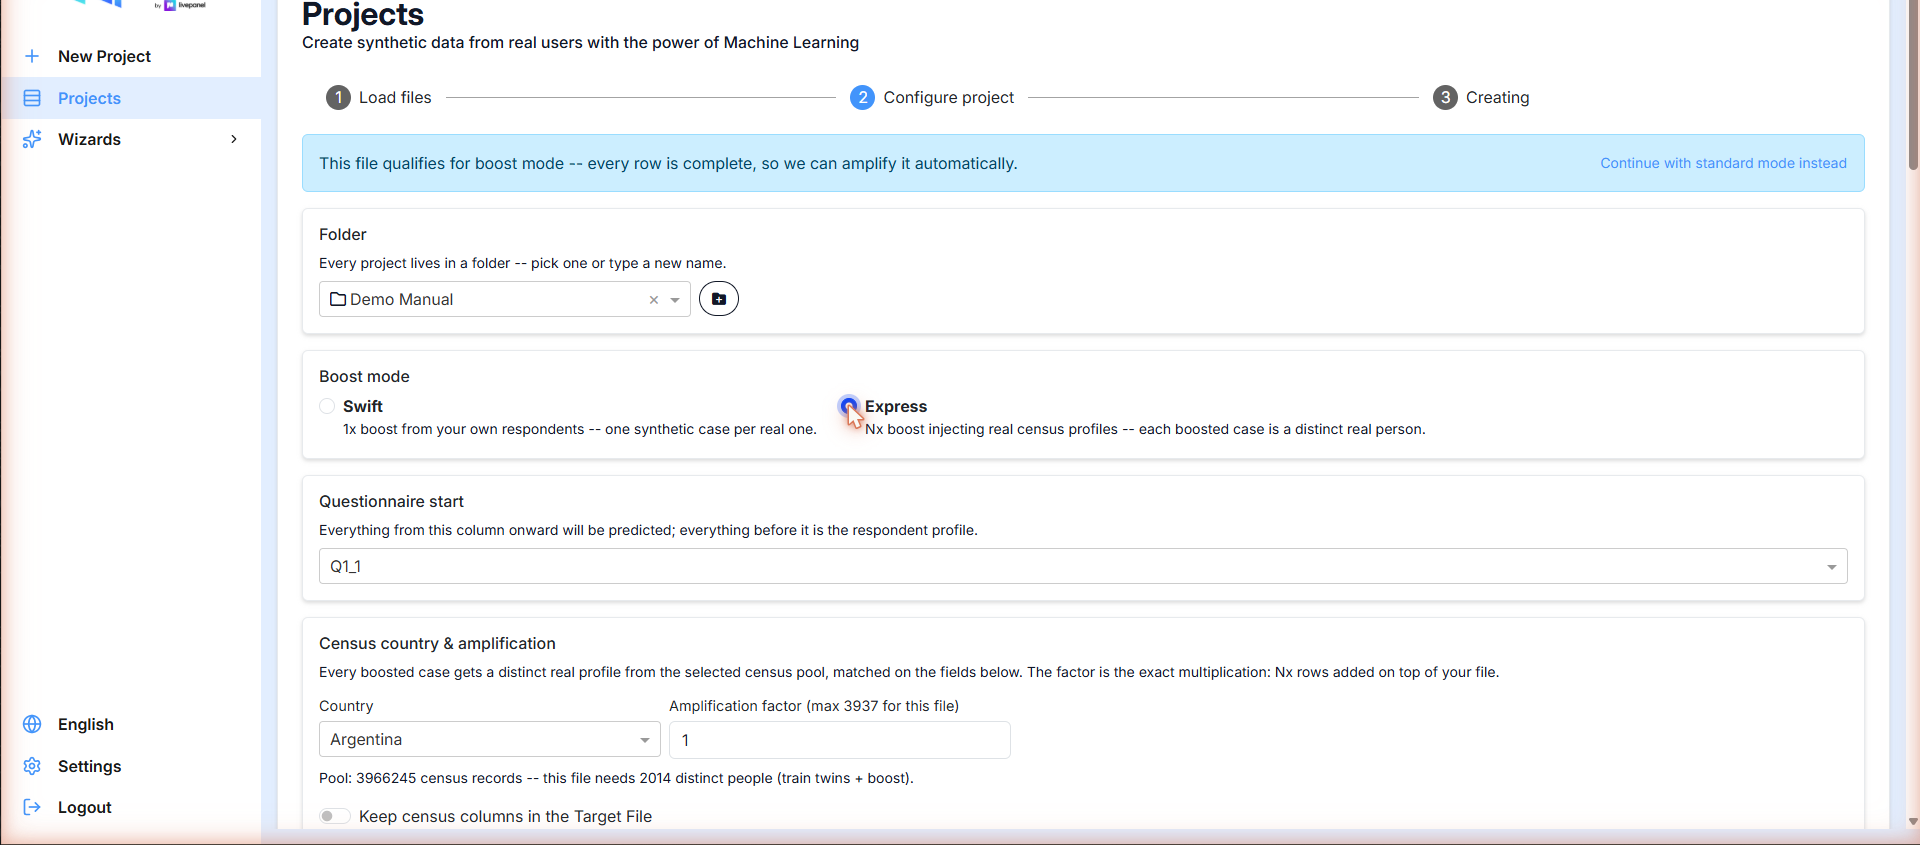
Страна переписи и усиление
Выберите пул переписи и степень усиления:
- Country — один из пулов переписи, зарегистрированных для вашей организации. На экране отображается размер пула и количество уникальных людей, необходимых для вашего файла (train twins + boost) — например, пул из 3 966 245 записей для файла, которому требуется 2 014 уникальных людей.
- Amplification factor — точное умножение: N× строк, добавленных к вашему файлу. Максимум рассчитывается для каждого файла из пула (3 937× для демонстрационного файла). Это ключевое отличие от Swift, который ограничен 1×.
- Keep census columns in the Target File — по умолчанию отключено: загруженный Target File удаляет внедренный блок переписи, хотя модель все еще обучается с ним. Включите эту опцию, если вы хотите, чтобы поля переписи были в конечном результате.
Целевые квоты вместо коэффициента
По умолчанию вы указываете Express, насколько умножить, и считываете результат. Переключатель Set target quotas and derive the factor automatically меняет это: вы говорите, сколько кейсов вы хотите на сегмент, и сервер сам вычисляет коэффициент.
Введите общую сумму, которую вы хотите получить для каждого сегмента ниже. Сервер сам вычисляет коэффициент умножения (с запасом на дедупликацию) и генерирует недостающие кейсы с реальными данными переписи — даже для комбинаций, которых нет в вашем файле.
Последнее предложение является ключевым: сегмент, в котором нет реальных кейсов в вашем файле, все равно будет предоставлен, построенный на основе записей переписи. В режиме коэффициента пустая ячейка остается пустой, потому что нечего умножать.
Включение переключателя скрывает Amplification factor, строку пула, предупреждение о превышении емкости, главный ползунок Overall % и столбец Max boost — ни один из них не имеет значения после вычисления коэффициента. В сетке Available показывает —, а Requested становится свободным числом без верхнего предела.
Общий и режим ввода
Под переключателем появляются два элемента управления:
- Total cases to deliver — размер конечного результата.
- Quotas entered as — Cases или Percentage of the total. Переключение преобразует все, что вы уже ввели, так что вы можете начать с процентов и проверить числа в кейсах.
Цели по измерениям
Вместо заполнения взаимосвязанной сетки ячейка за ячейкой, карточка Targets per dimension принимает одно число для каждого сегмента каждого поля сегментации — одно для каждой возрастной группы, одно для каждого пола и так далее. Каждая строка показывает свою текущую сумму по сравнению с ожидаемой общей суммой.
Как только каждое измерение суммируется до одной и той же общей суммы, цели автоматически распределяются по взаимосвязанной сетке, и карточка подтверждает "Applied to the grid: N total cases." Если они не совпадают, появляется предупреждение "Each dimension must add up to N." — ничего не применяется, пока они не согласятся.
Вы все еще можете редактировать любую ячейку сетки вручную после этого. Строка под сеткой напоминает вам: "The grid adds up to N cases — global target M.", зеленая, когда они совпадают.
Приоритет ослабления
Каждое измерение имеет поле Relax priority, по умолчанию пустое (отображается как Protected):
- Left empty — измерение соответствует точно. Используйте это для квоты, которую вы фактически обязались предоставить клиенту.
- A number — измерение может заимствовать между своими собственными сегментами, если ячейка не соответствует требованиям. 1 relaxes before 2.
Именно это позволяет взаимосвязанной сетке вообще закрываться: что-то должно уступить, когда у ячейки нет кандидатов, и это определяет, что уступает первым.
Параметры квоты
Два переключателя, оба включены по умолчанию, определяют, что происходит на границах. Оба изменяют количество строк, которые вы получаете, поэтому прочитайте их перед первой доставкой:
| Опция | Включено (по умолчанию) | Выключено |
|---|---|---|
| Guarantee the full count | Любой оставшийся дефицит восполняется оставшимися сгенерированными строками, которые не принадлежат к невыполненному сегменту, поэтому общая сумма всегда доставляется | Сегмент сообщает о дефиците, и общая сумма оказывается меньше |
| Keep every real respondent | Ни один реальный кейс никогда не отбрасывается — сегмент с большим количеством реальных кейсов, чем его квота, увеличивает общую сумму выше цели | Реальные кейсы конкурируют за свой сегмент, и излишек отбрасывается, точно соответствуя цели |
Какая комбинация вам нужна?
Оставьте оба включенными, когда количество никогда не должно быть меньше, и небольшой перебор допустим. Отключите Keep every real respondent, когда результат должен точно соответствовать N. Отключите Guarantee the full count, когда вы предпочли бы увидеть честный дефицит, чем строки, заполняющие сегмент, к которому они не принадлежат.
Сопоставление с переписью
Поля профиля, используемые для выбора двойника переписи для каждого усиленного кейса. Предварительно заполняются из сохраненных совпадений страны, если они доступны, а Suggest with IA предлагает вам сопоставление:
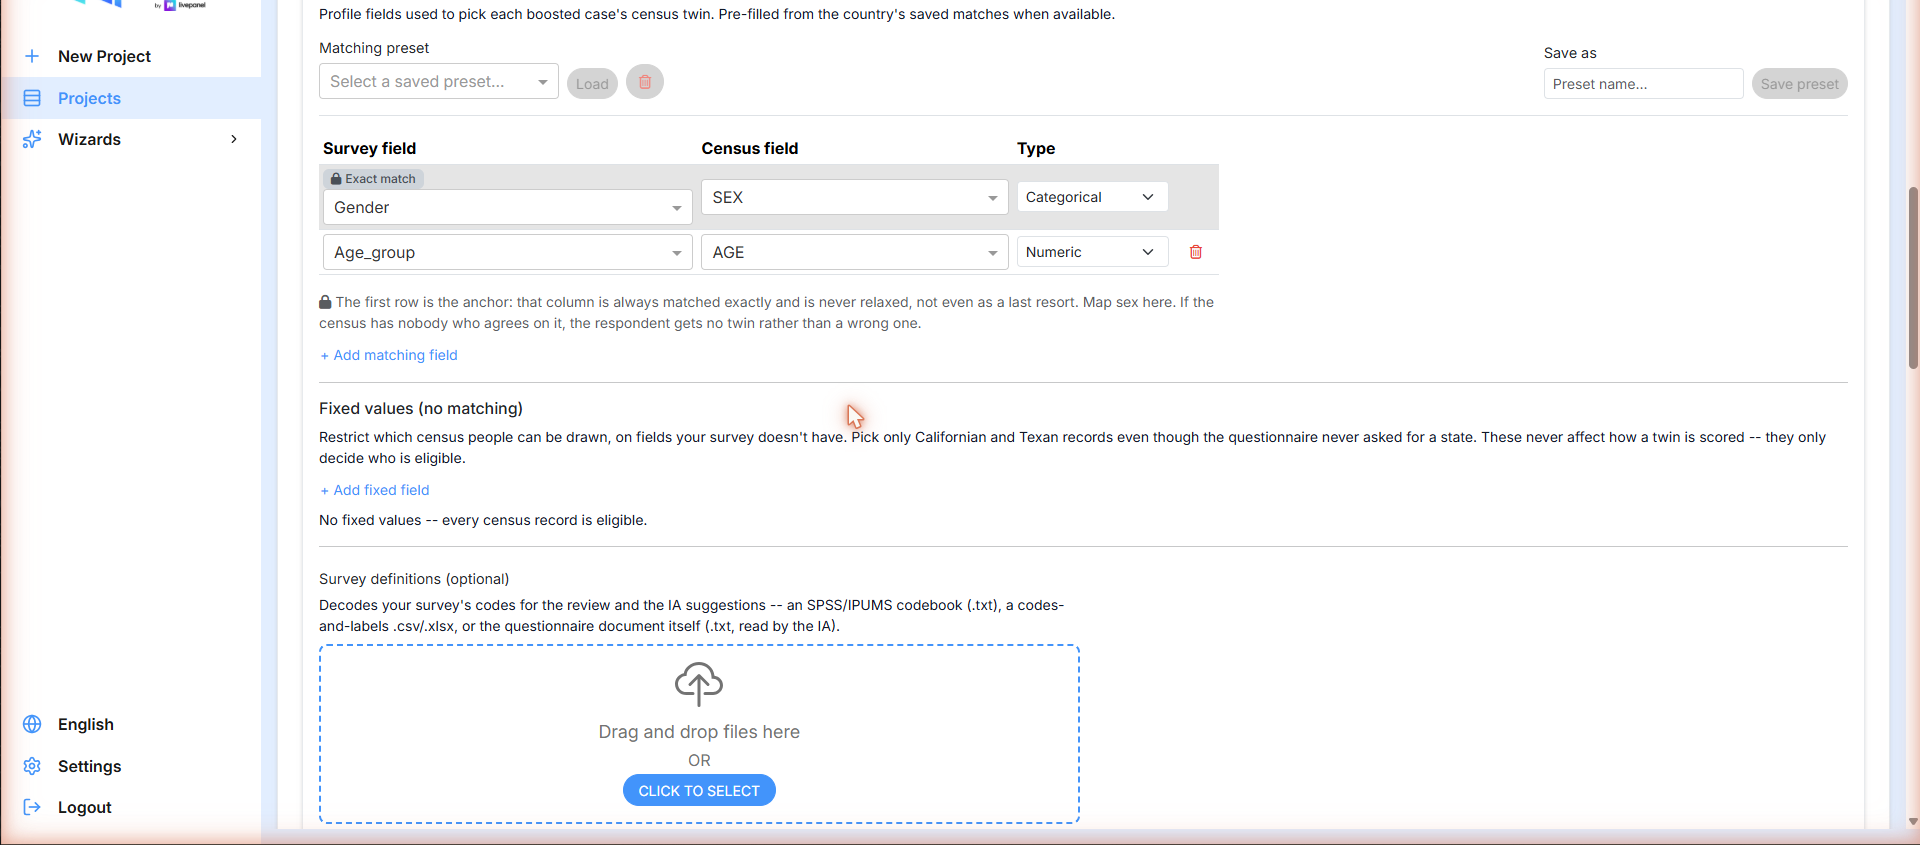
Каждая строка сопоставляет Survey field с Census field с Type (Categorical, Numeric, Geographic или Exact):
- The first row is the anchor (заблокировано как Exact match): этот столбец всегда сопоставляется точно и никогда не ослабляется, даже в крайнем случае. Сопоставьте здесь пол. Если в переписи нет никого, кто согласен с этим, респондент получает no twin rather than a wrong one.
- Matching preset — сохраните сопоставление под именем и перезагрузите его для следующего проекта в той же стране.
- Fixed values (no matching) — ограничьте, какие люди из переписи могут быть выбраны, по полям, которых нет в вашем опросе (например, только записи из Калифорнии и Техаса, хотя в анкете никогда не спрашивали о штате). Это никогда не влияет на оценку двойника; они только определяют, кто имеет право.
- Survey definitions (optional) — загрузите кодовую книгу SPSS/IPUMS (
.txt), файл.csv/.xlsxс кодами и метками, или сам документ анкеты, чтобы ИИ мог декодировать коды вашего опроса при проверке и в своих предложениях.
Проверка сопоставления значений
Перед началом проверьте, как каждый код опроса сочетается с кодами переписи. Числовые поля (например, возраст) автоматически сопоставляются по расстоянию и не требуют проверки; Suggest values with IA заполняет остальное:
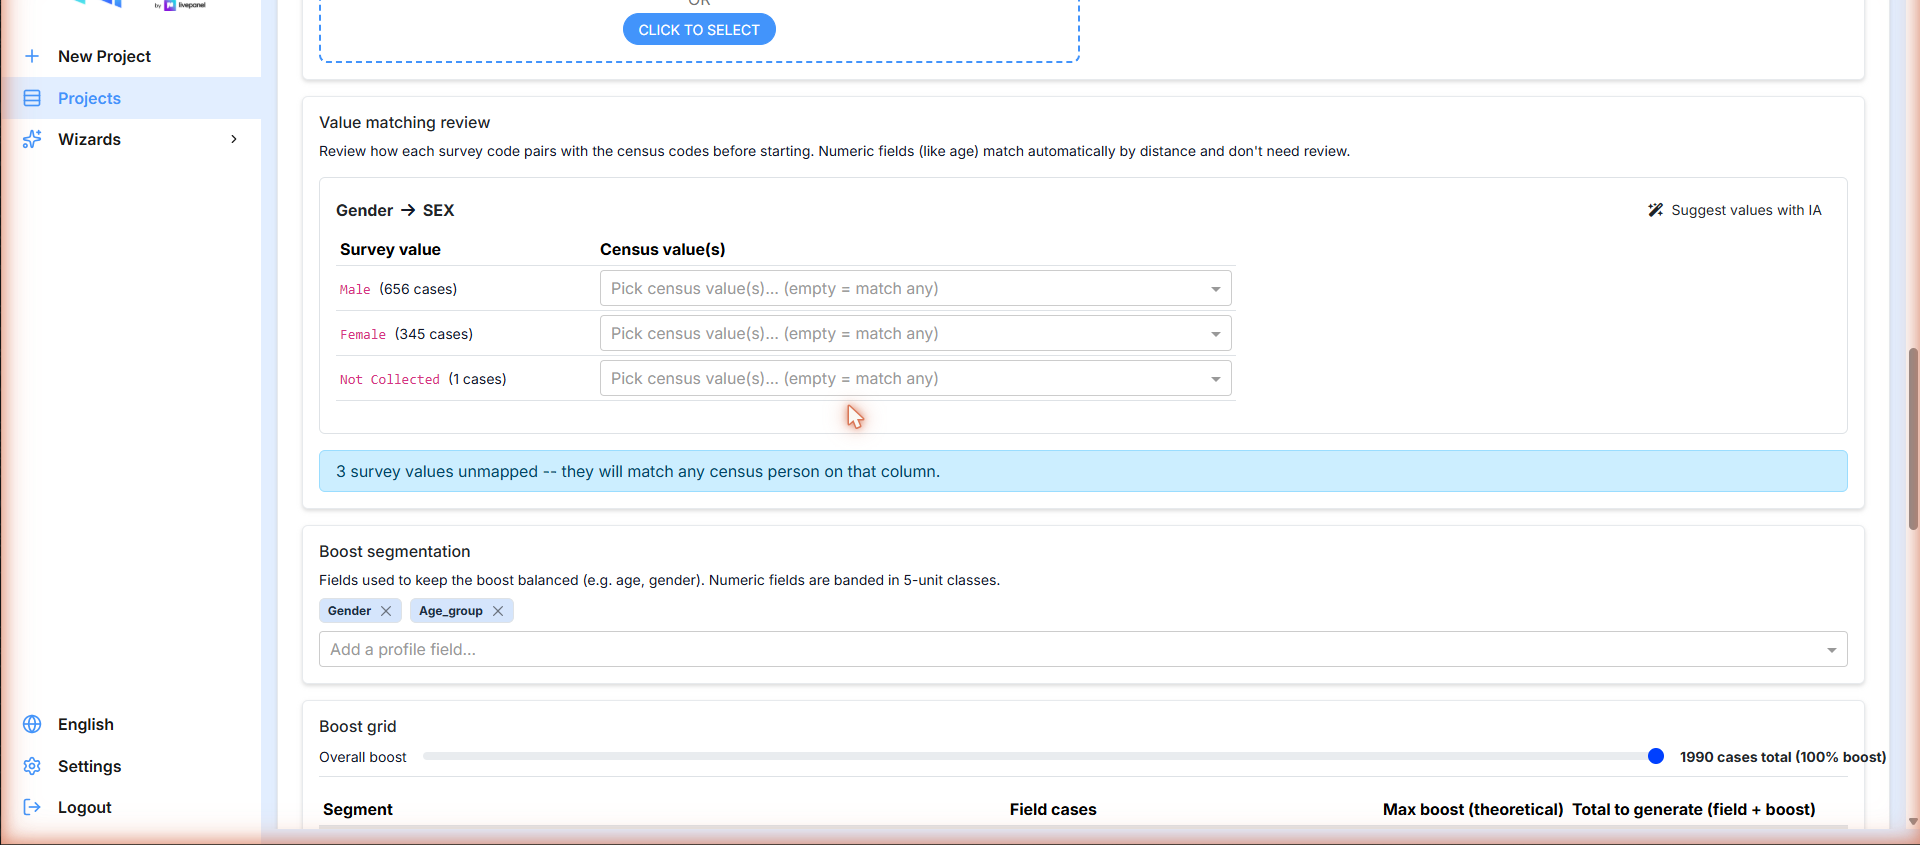
Каждое значение опроса показывает количество кейсов и значение(я) переписи, с которыми оно сопоставляется. Оставление значения пустым означает match any — на экране отображается, сколько значений не сопоставлено, чтобы ничего не проскользнуло незаметно.
Сетка усиления, параметры баланса и запуск
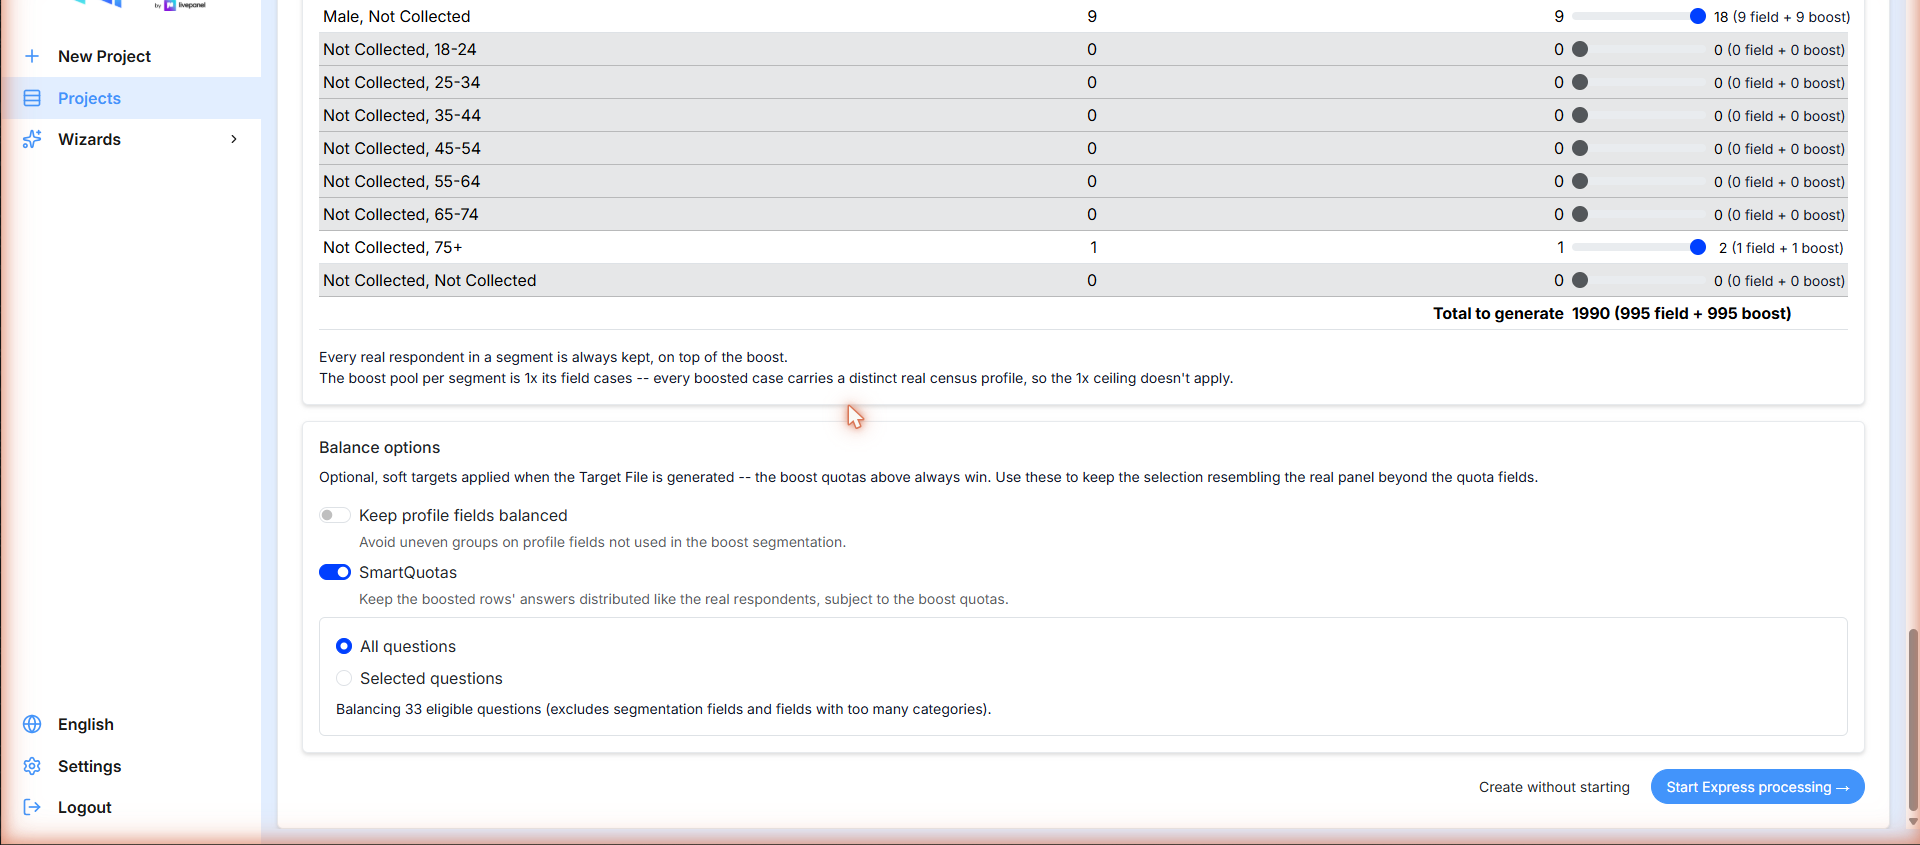
Сегментация и сетка усиления работают так же, как в Swift, с одним отличием в верхнем пределе:
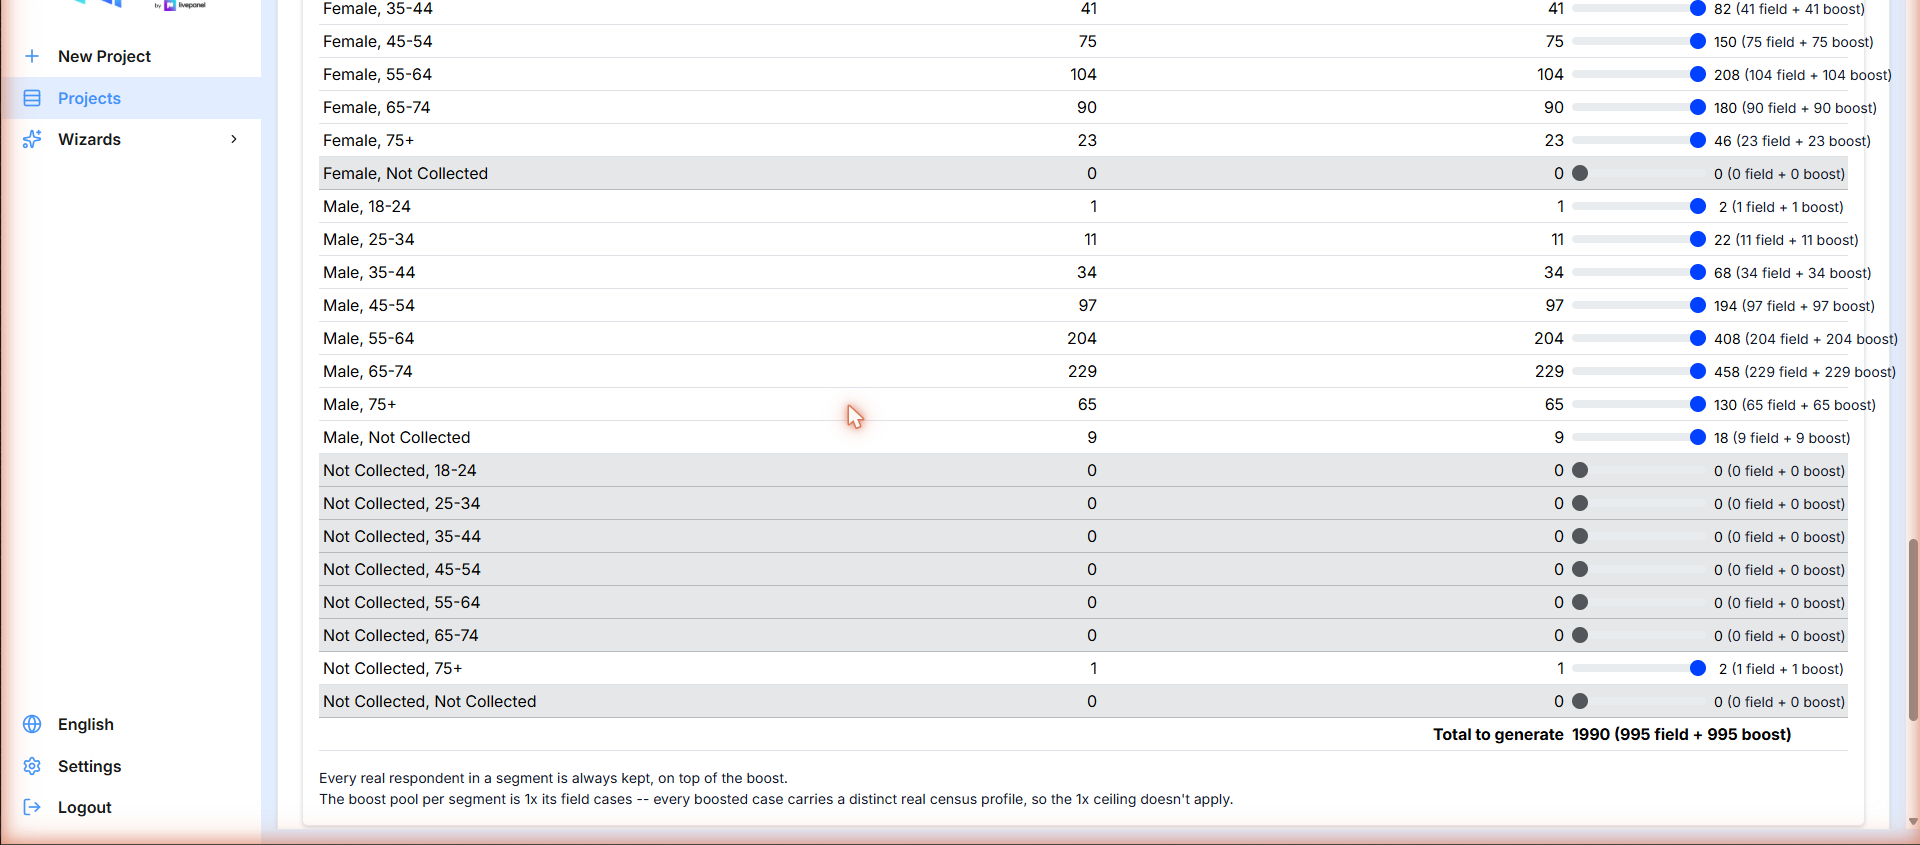
Каждый реальный респондент в сегменте всегда сохраняется, помимо усиления. Пул усиления на сегмент составляет N× его полевых кейсов — каждый усиленный кейс несет отдельный реальный профиль переписи, поэтому потолок 1× не применяется.
В режиме целевых квот нижний колонтитул читается по-другому, потому что нет верхнего предела для указания: "The factor is derived from these targets on the server. Segments without enough real cases — including empty ones — are completed with census-based generated rows."
Balance options и SmartQuotas ведут себя точно так же, как в Swift. Завершите с помощью Start Express processing или Create without starting, чтобы оставить проект в состоянии Created: