Modos de impulso: Swift y Express
Cuando los archivos no contienen información adicional de perfilado de casos, n-Infinite ofrece dos modos diseñados para amplificar casos utilizando perfiles de entrenamiento sólidos o solo datos demográficos.
Cuando un archivo cargado califica —cada fila está completa— el paso de configuración ofrece el modo de impulso automáticamente (siempre puede continue with standard mode instead):
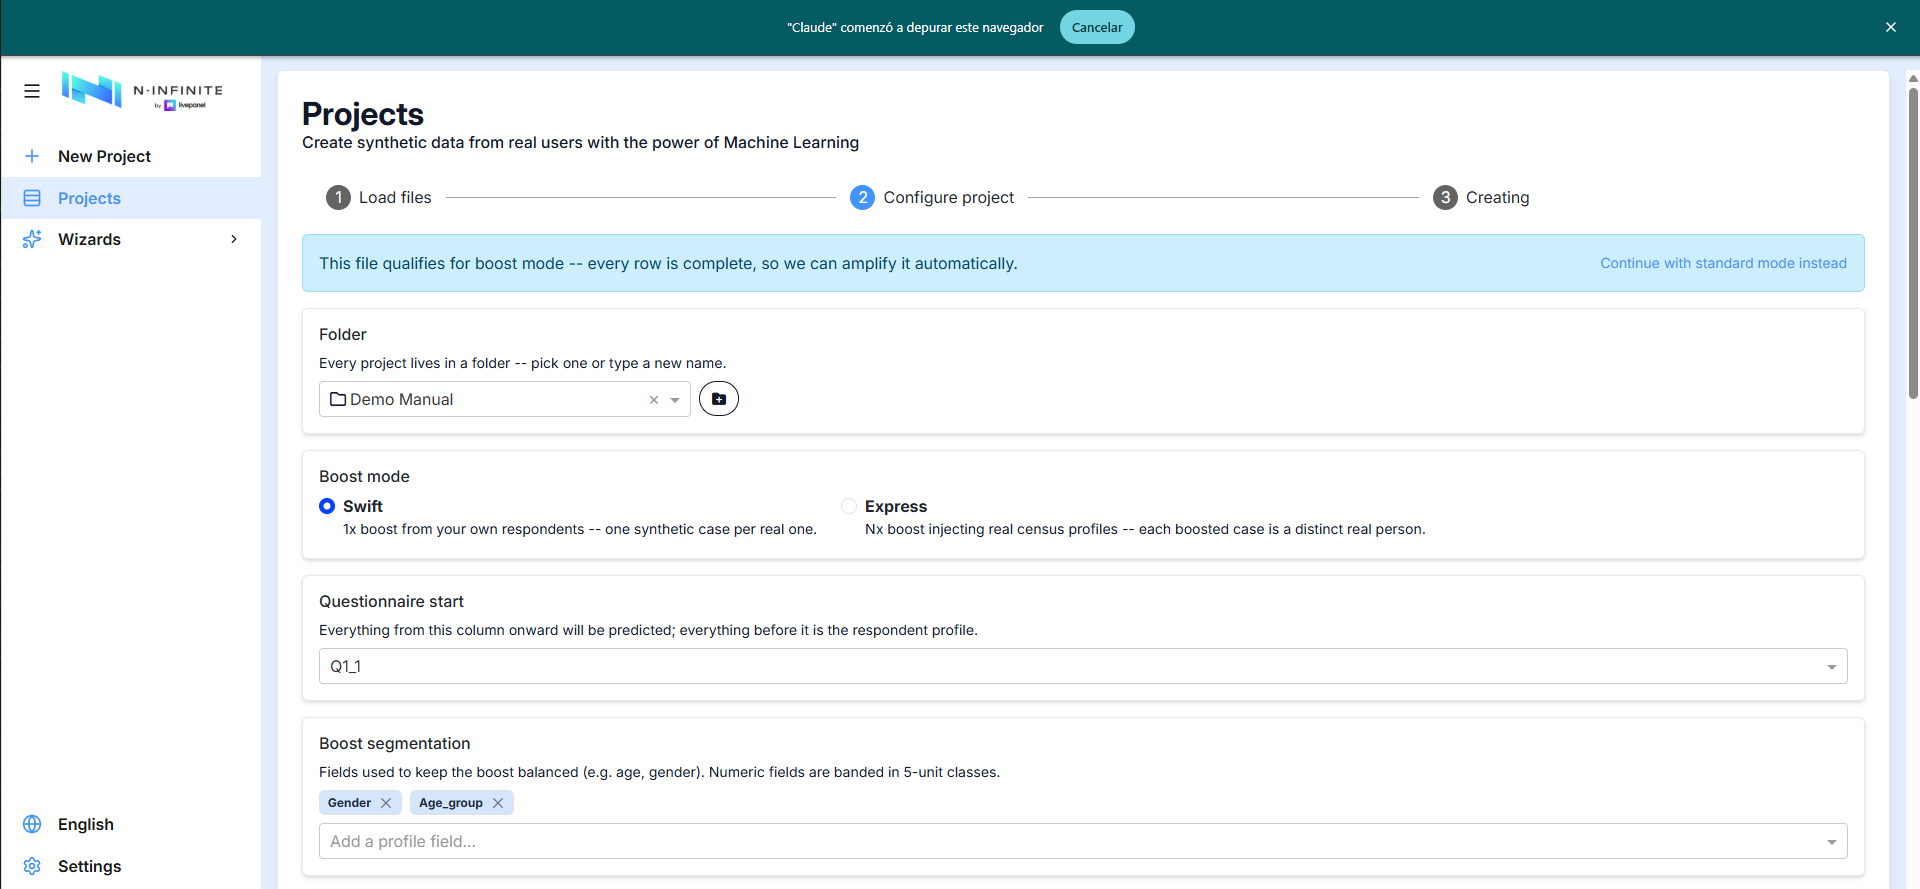
- Swift — Impulso 1× de sus propios encuestados: un caso sintético por cada caso real.
- Express — Impulso N× inyectando perfiles censales reales: cada caso impulsado es una persona real distinta. Requiere países censales registrados para su organización (pregunte a un administrador).
Modo Swift
Swift proporciona una amplificación de hasta el 100% de los casos (típicamente alrededor del 50%) con perfiles de origen de alta calidad, duplicando esos perfiles y volviendo a predecir esos casos. Se recomienda para proyectos B2B con escasez de perfiles de predicción.
Dado que el entrenamiento de ML no es absolutamente exacto para cada caso —cierta aleatoriedad está involucrada en la selección de casos de entrenamiento y validación— Swift introduce variaciones menores que añaden diversidad mientras mantienen la distribución de cada cuota.
La selección clave es el inicio del cuestionario: todo desde esa columna en adelante se predice; todo lo anterior es el perfil del encuestado.
Segmentación de impulso y la cuadrícula de impulso
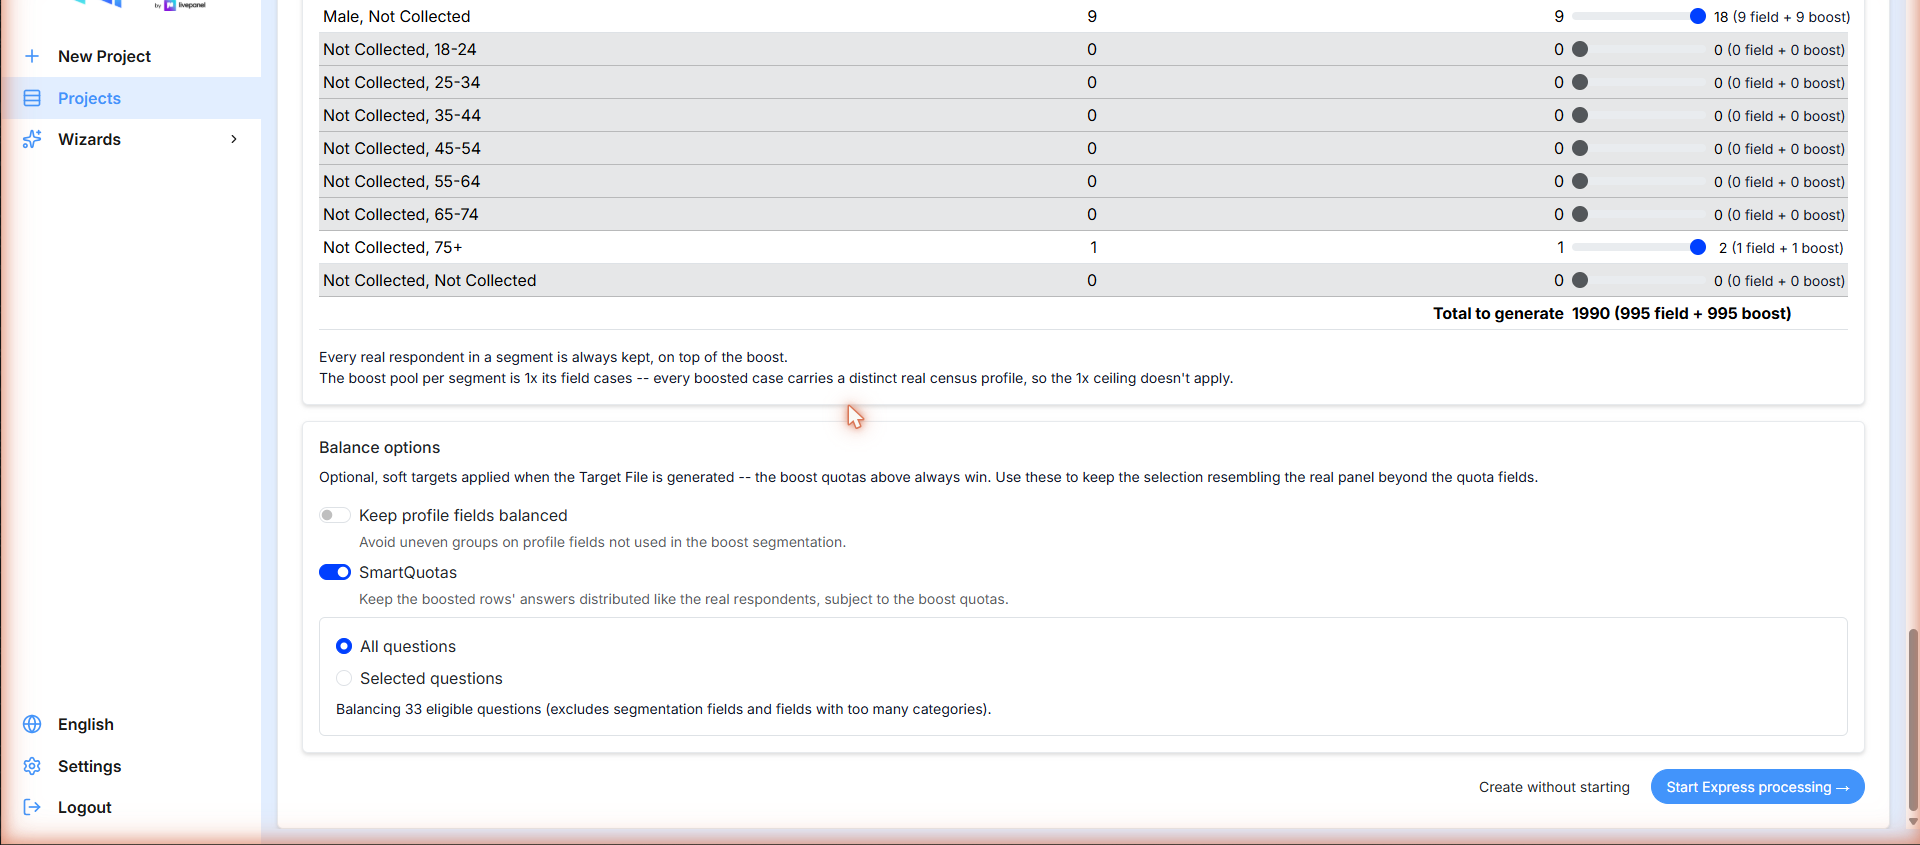
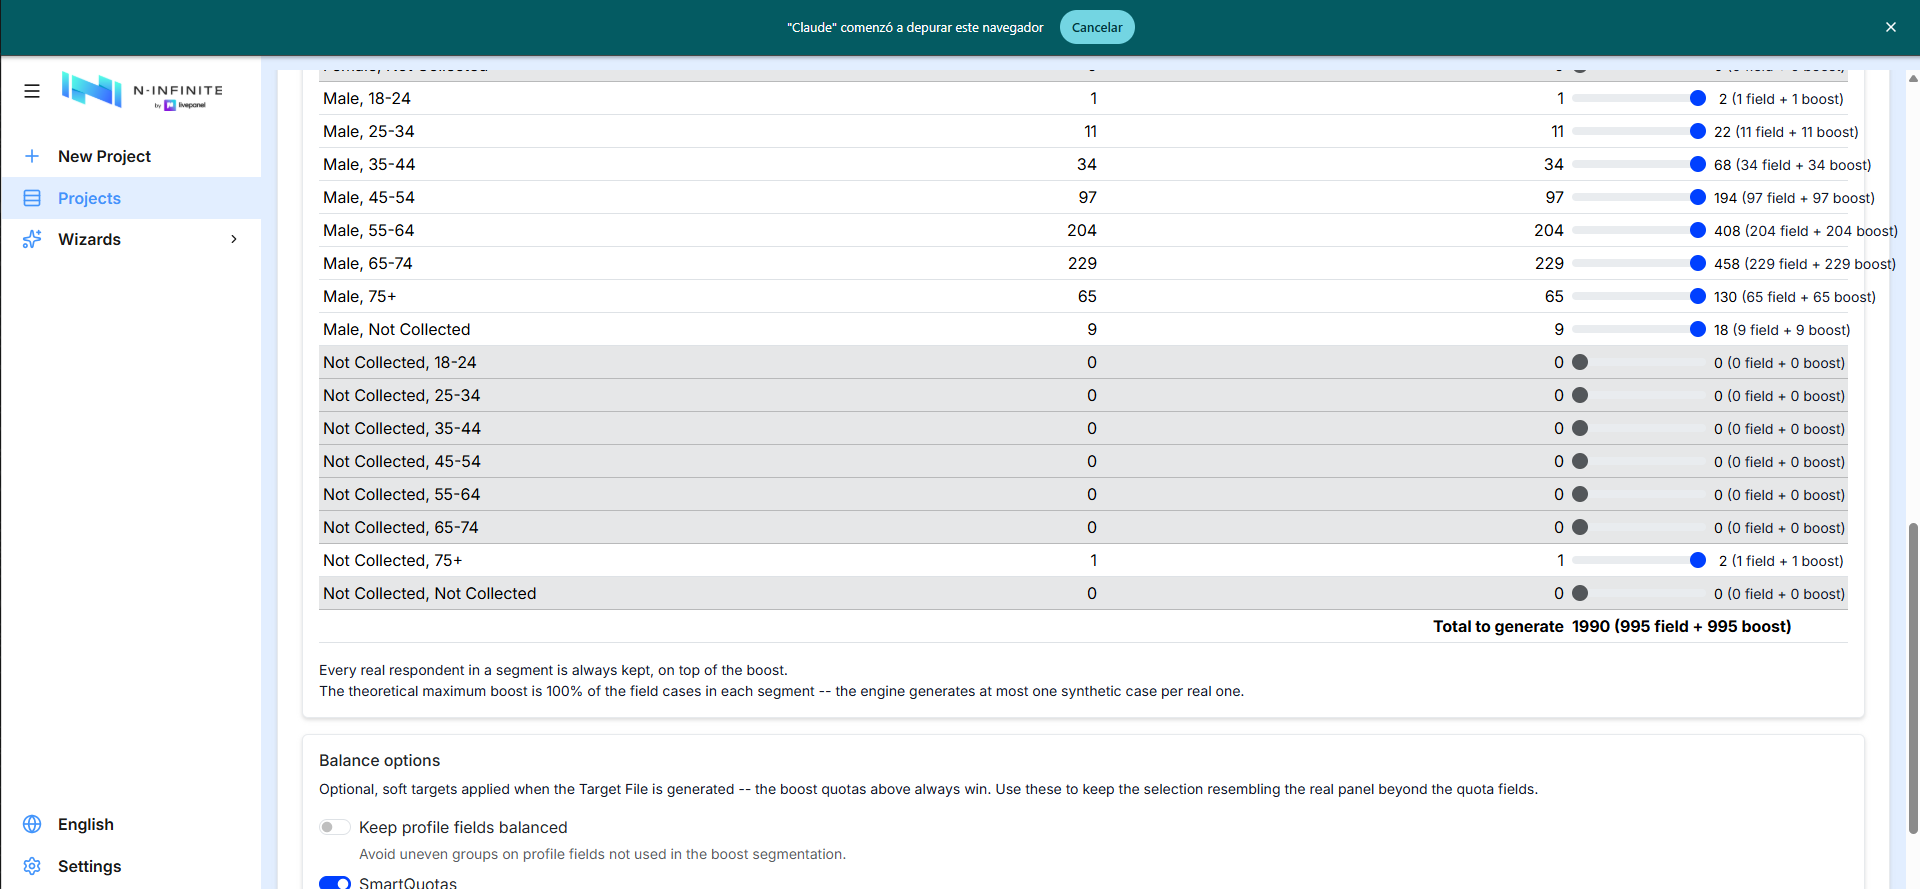
Elija los campos que mantienen el impulso equilibrado (por ejemplo, género, grupo de edad — los campos numéricos se agrupan automáticamente). La cuadrícula de impulso luego muestra cada combinación de segmento con sus casos de campo y un deslizador para establecer cuántos casos sintéticos agregar por celda, más el total acumulado:
Dos reglas a tener en cuenta:
- Cada encuestado real en un segmento siempre se mantiene, además del impulso.
- El impulso máximo teórico es el 100% de los casos de campo en cada segmento — el motor genera como máximo un caso sintético por cada caso real.
Opciones de Balance & SmartQuotas
Objetivos flexibles opcionales aplicados cuando se genera el archivo objetivo — las cuotas de impulso anteriores siempre prevalecen:
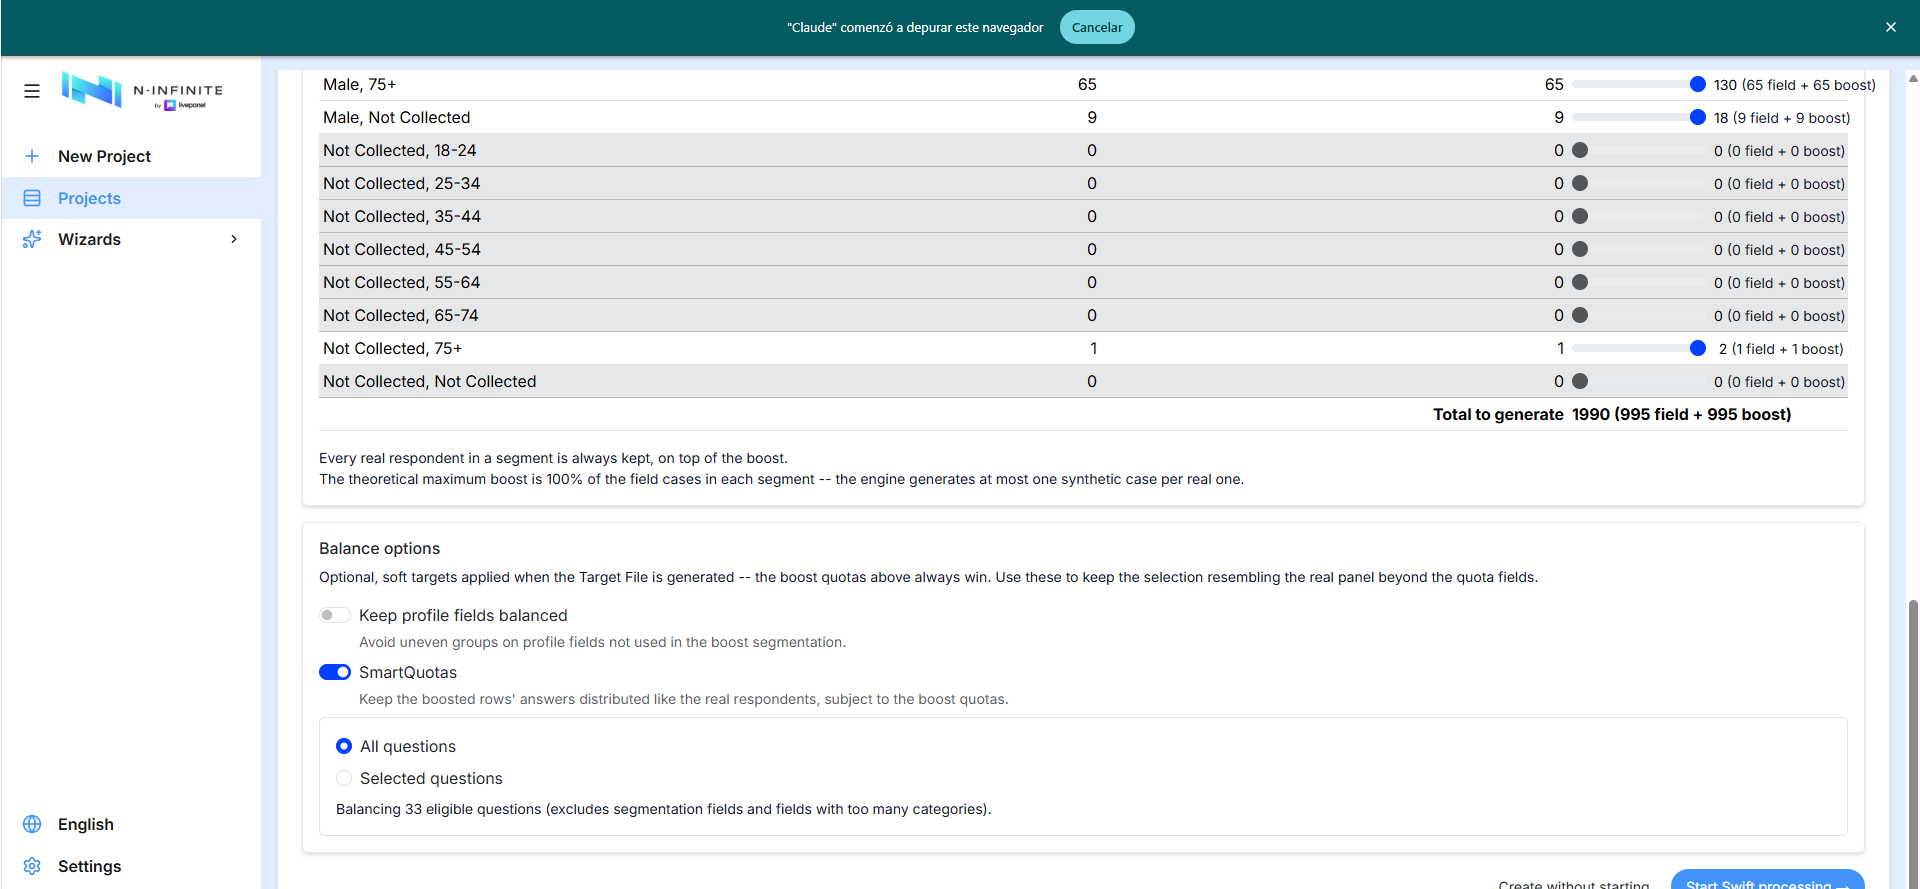
- Keep profile fields balanced — evita grupos desiguales en campos de perfil no utilizados en la segmentación de impulso.
- SmartQuotas — mantiene las answers de las filas impulsadas distribuidas como los encuestados reales, sujeto a las cuotas de impulso. Equilibrio en todas las preguntas, o elija las key columns donde las proporciones son críticas (los campos de segmentación y los campos con demasiadas categorías se excluyen automáticamente).
Finalmente, Start Swift processing inicia el impulso inmediatamente, o Create without starting deja el proyecto en estado Created para más tarde.
Salidas de impulso
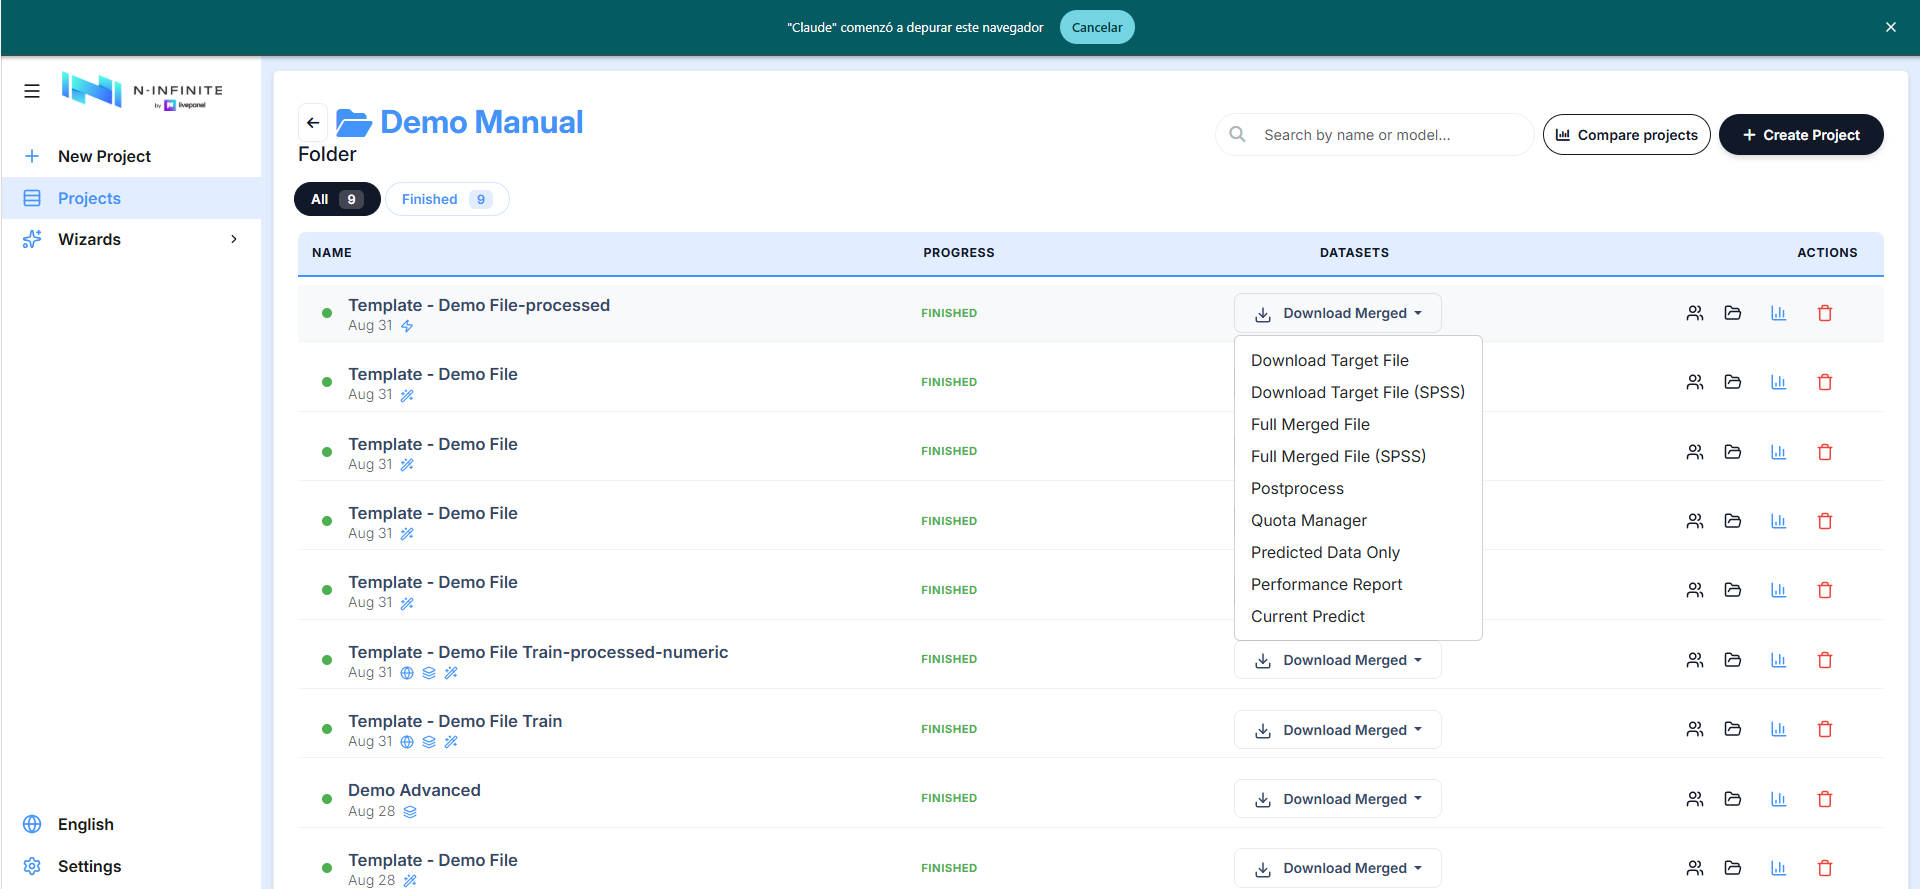
Un proyecto de impulso finalizado añade descargas dedicadas en la parte superior de su menú Download Merged — el Target File (el entregable impulsado) en Excel o SPSS:
Modo Express
Express se dirige a grandes impulsos y proyectos B2C. A diferencia de Swift —que reutiliza el perfil de cada caso— Express inyecta un perfil censal real distinto en cada caso impulsado, de modo que cada encuestado sintético se modela a partir de una persona real diferente. Se recomienda el post-ponderación.
Note
Express necesita países censales registrados para su organización. Si la opción está deshabilitada con "No census countries registered", contacte al equipo de n-Infinite.
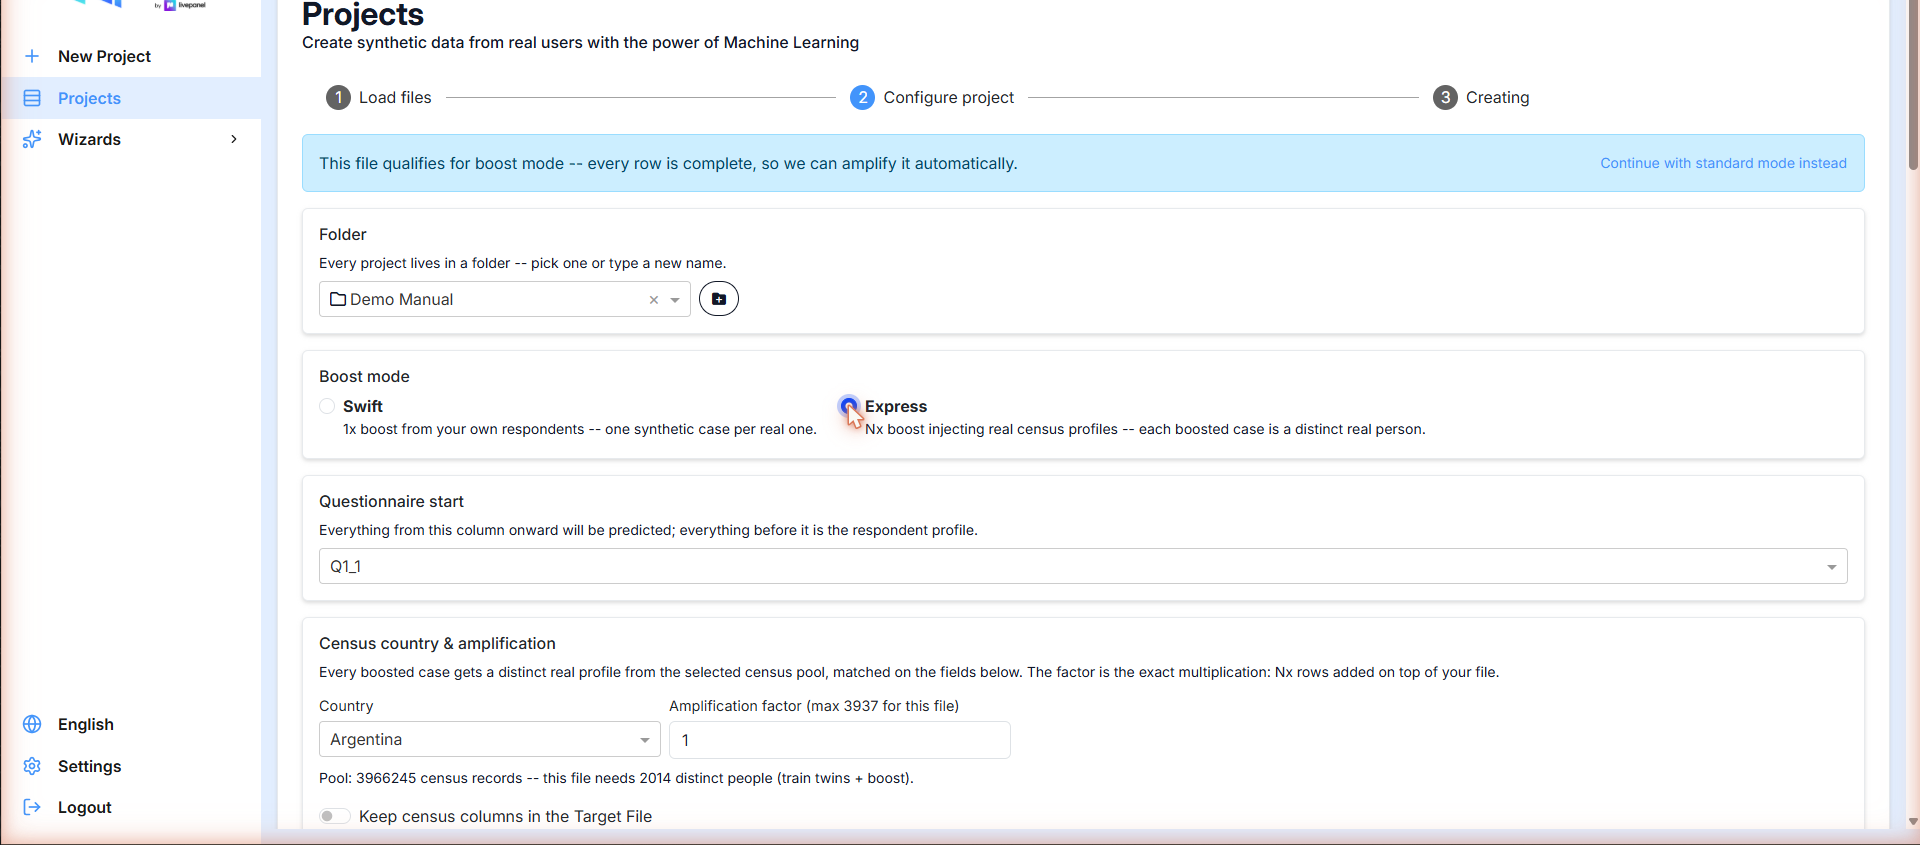
Elija Express en el bloque Boost mode:
País censal y amplificación
Elija el grupo censal y cuánto amplificar:
- Country — uno de los grupos censales registrados para su organización. La pantalla informa el tamaño del grupo y cuántas personas distintas necesita su archivo (train twins + boost) — por ejemplo, un grupo de 3,966,245 registros para un archivo que necesita 2,014 personas distintas.
- Amplification factor — la multiplicación exacta: N× filas añadidas además de su archivo. El máximo se calcula por archivo a partir del grupo (3,937× para el archivo de demostración). Esta es la diferencia clave con Swift, que está limitado a 1×.
- Keep census columns in the Target File — desactivado por defecto: el Target File descargado elimina el bloque censal inyectado, aunque el modelo todavía entrena con él. Actívelo si desea los campos censales en el entregable.
Cuotas objetivo en lugar de un factor
Por defecto, usted le dice a Express cuánto multiplicar y lee el resultado. El interruptor Set target quotas and derive the factor automatically invierte esto: usted dice cuántos casos desea por segmento, y el servidor calcula el factor por sí mismo.
Introduzca el total que desea por segmento a continuación. El servidor calcula el factor de multiplicación por sí mismo (con un margen para la deduplicación) y genera los casos faltantes con datos censales reales — incluso para combinaciones que no existen en su archivo.
Esa última cláusula es el punto: un segmento sin casos reales en su archivo se entrega de todos modos, construido a partir de registros censales. En el modo de factor, una celda vacía permanece vacía, porque no hay nada que multiplicar.
Activar el interruptor oculta el Amplification factor, la línea del grupo, la advertencia de sobrecapacidad, el deslizador maestro Overall % y la columna Max boost — ninguno de ellos significa nada una vez que se deriva el factor. En la cuadrícula, Available muestra — y Requested se convierte en un número libre sin límite.
Total y modo de entrada
Aparecen dos controles debajo del interruptor:
- Total cases to deliver — el tamaño del entregable final.
- Quotas entered as — Cases o Percentage of the total. Al cambiar, se convierte lo que ya haya escrito, para que pueda empezar en porcentajes y verificar los números en casos.
Objetivos por dimensión
En lugar de rellenar una cuadrícula interlocked celda por celda, la tarjeta Targets per dimension toma un número por cada segmento de cada campo de segmentación — uno por rango de edad, uno por género, y así sucesivamente. Cada fila muestra su suma acumulada frente al total esperado.
Tan pronto como cada dimensión suma el mismo total, los objetivos se incorporan automáticamente a la cuadrícula interlocked y la tarjeta confirma "Applied to the grid: N total cases." Mientras no lo hagan, advierte "Each dimension must add up to N." — nada se aplica hasta que coincidan.
Aún puede editar cualquier celda de la cuadrícula manualmente después. Una línea debajo de la cuadrícula le mantiene informado: "The grid adds up to N cases — global target M.", en verde cuando coinciden.
Prioridad de relajación
Cada dimensión tiene un campo Relax priority, vacío por defecto (mostrado como Protected):
- Left empty — la dimensión se iguala exactamente. Utilice esto para la cuota que realmente se comprometió con un cliente.
- A number — la dimensión puede tomar prestado entre sus propios segmentos cuando una celda no alcanza. 1 se relaja antes que 2.
Esto es lo que permite que una cuadrícula interlocked se cierre: algo tiene que ceder cuando una celda no tiene candidatos, y esto indica qué cede primero.
Opciones de cuota
Dos interruptores, ambos activados por defecto, deciden qué sucede en los límites. Ambos cambian el recuento de filas que recibe, así que léalos antes de su primera entrega:
| Opción | Activado (por defecto) | Desactivado |
|---|---|---|
| Guarantee the full count | Cualquier déficit restante se completa con filas generadas sobrantes que no pertenecen al segmento no cumplido, por lo que el total siempre se entrega | El segmento reporta un déficit y el total es menor |
| Keep every real respondent | Ningún caso real se elimina — un segmento con más casos reales que su cuota empuja el total por encima del objetivo | Los casos reales compiten por su segmento y el excedente se elimina, aterrizando exactamente en el objetivo |
¿Qué combinación desea?
Deje ambos activados cuando el recuento nunca deba ser menor y un pequeño exceso sea aceptable. Desactive Keep every real respondent cuando el entregable deba aterrizar en un N exacto. Desactive Guarantee the full count cuando prefiera ver un déficit honesto en lugar de filas que llenan un segmento al que no pertenecen.
Coincidencia censal
Los campos de perfil utilizados para seleccionar el "gemelo" censal de cada caso impulsado. Pre-rellenados a partir de las coincidencias guardadas del país cuando están disponibles, y Suggest with IA propone el mapeo por usted:
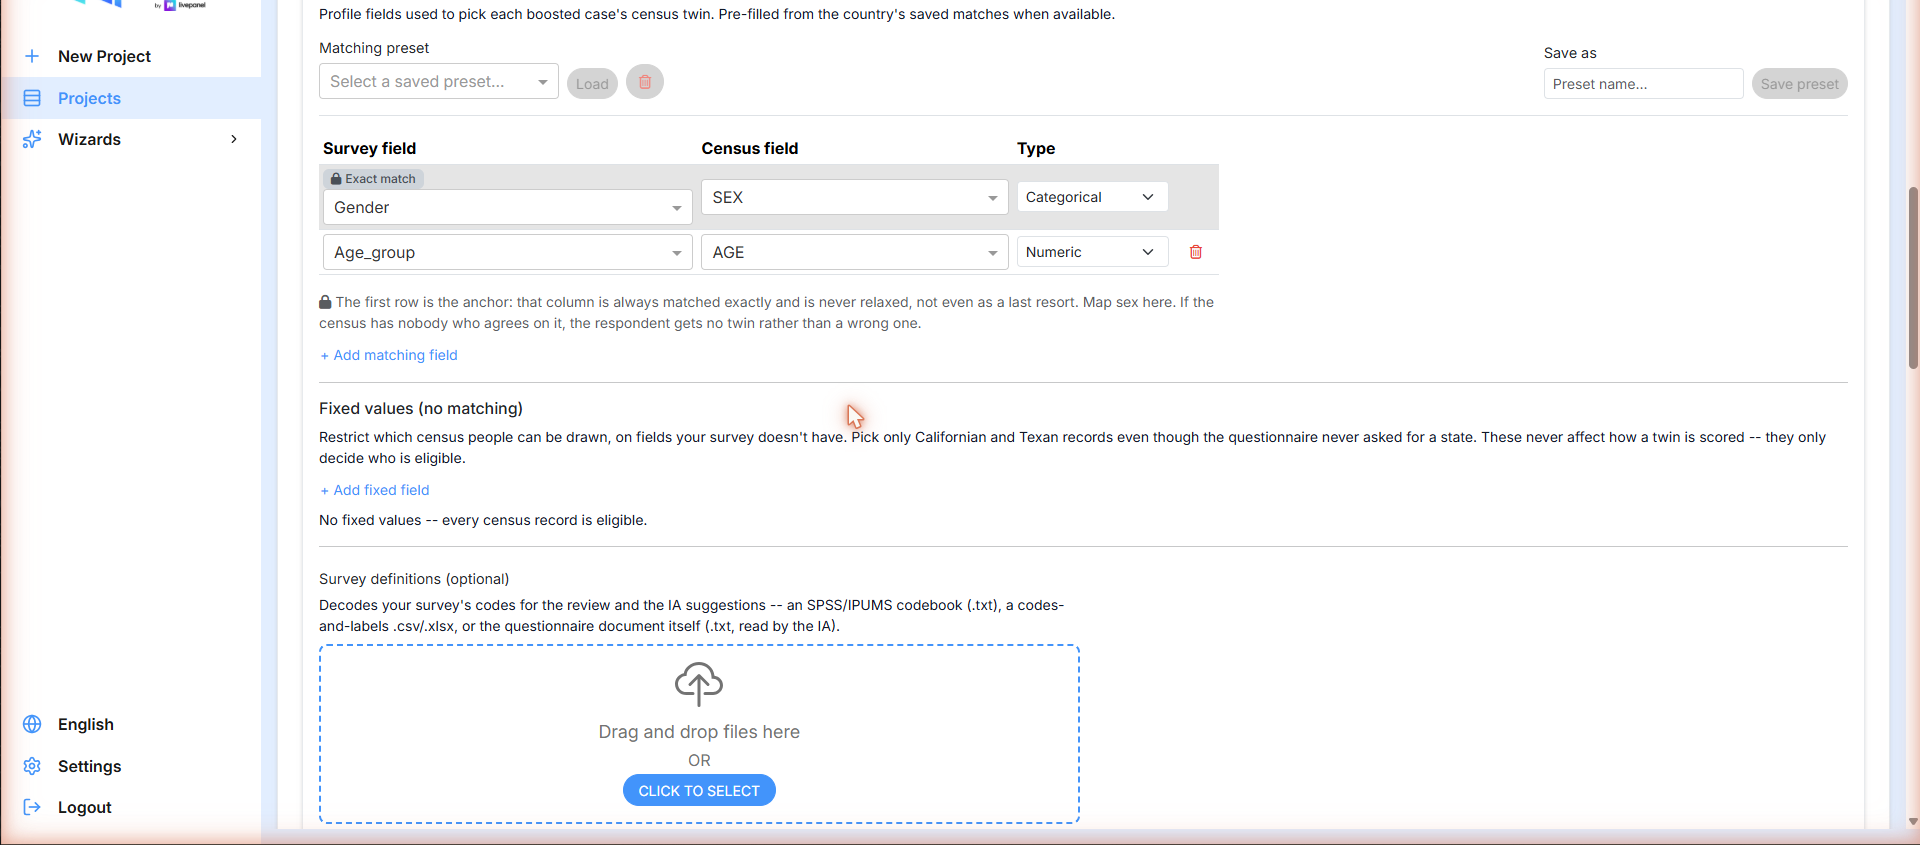
Cada fila mapea un Survey field a un Census field con un Type (Categorical, Numeric, Geographic o Exact):
- La primera fila es el ancla (bloqueada como Exact match): esa columna siempre se iguala exactamente y nunca se relaja, ni siquiera como último recurso. Mapee el sexo aquí. Si el censo no tiene a nadie que coincida, el encuestado obtiene ningún gemelo en lugar de uno incorrecto.
- Matching preset — guarde un mapeo con un nombre y recárguelo para el siguiente proyecto en el mismo país.
- Fixed values (no matching) — restringe qué personas del censo pueden ser seleccionadas, en campos que su encuesta no tiene (por ejemplo, solo registros de California y Texas aunque el cuestionario nunca preguntó por un estado). Estos nunca afectan cómo se puntúa un gemelo; solo deciden quién es elegible.
- Survey definitions (optional) — cargue un libro de códigos SPSS/IPUMS (
.txt), un archivo.csv/.xlsxde códigos y etiquetas, o el documento del cuestionario mismo, para que la IA pueda decodificar los códigos de su encuesta en la revisión y en sus sugerencias.
Revisión de coincidencia de valores
Antes de comenzar, revise cómo cada código de encuesta se empareja con los códigos censales. Los campos numéricos (como la edad) coinciden automáticamente por distancia y no necesitan revisión; Suggest values with IA completa el resto:
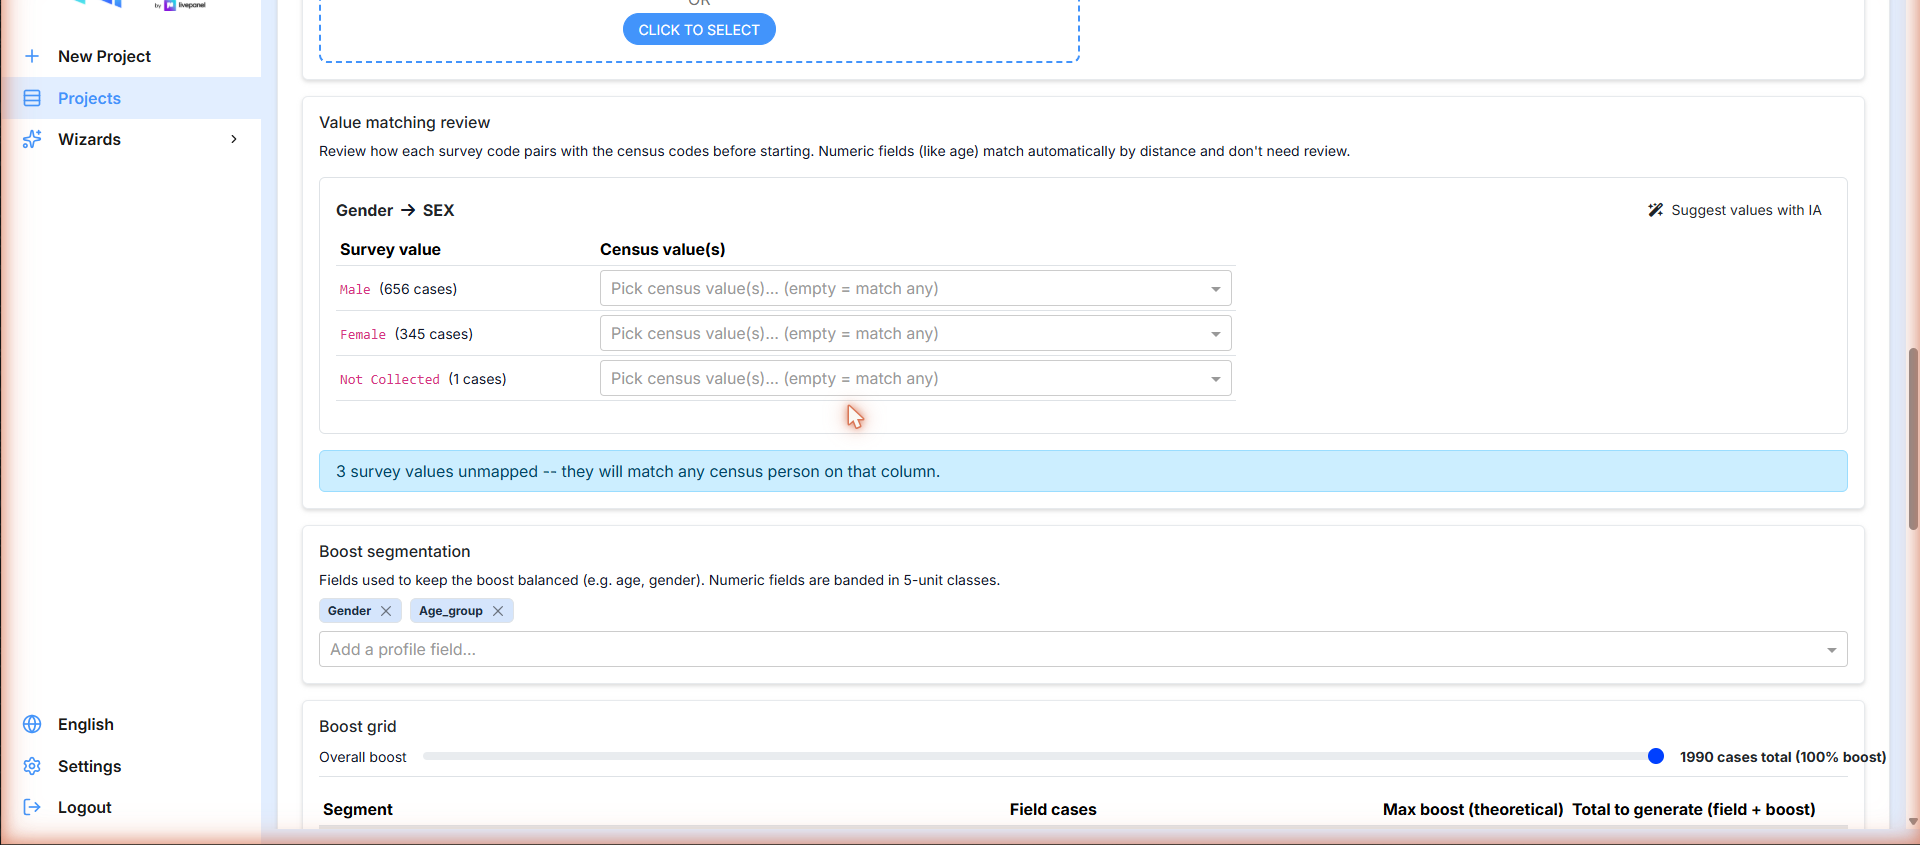
Cada valor de encuesta muestra su recuento de casos y el(los) valor(es) censal(es) al(a los) que se mapea. Dejar un valor vacío significa match any — la pantalla le indica cuántos valores no están mapeados para que nada se escape silenciosamente.
Cuadrícula de impulso, opciones de balance e inicio
La segmentación y la cuadrícula de impulso funcionan como en Swift, con una diferencia en el límite:
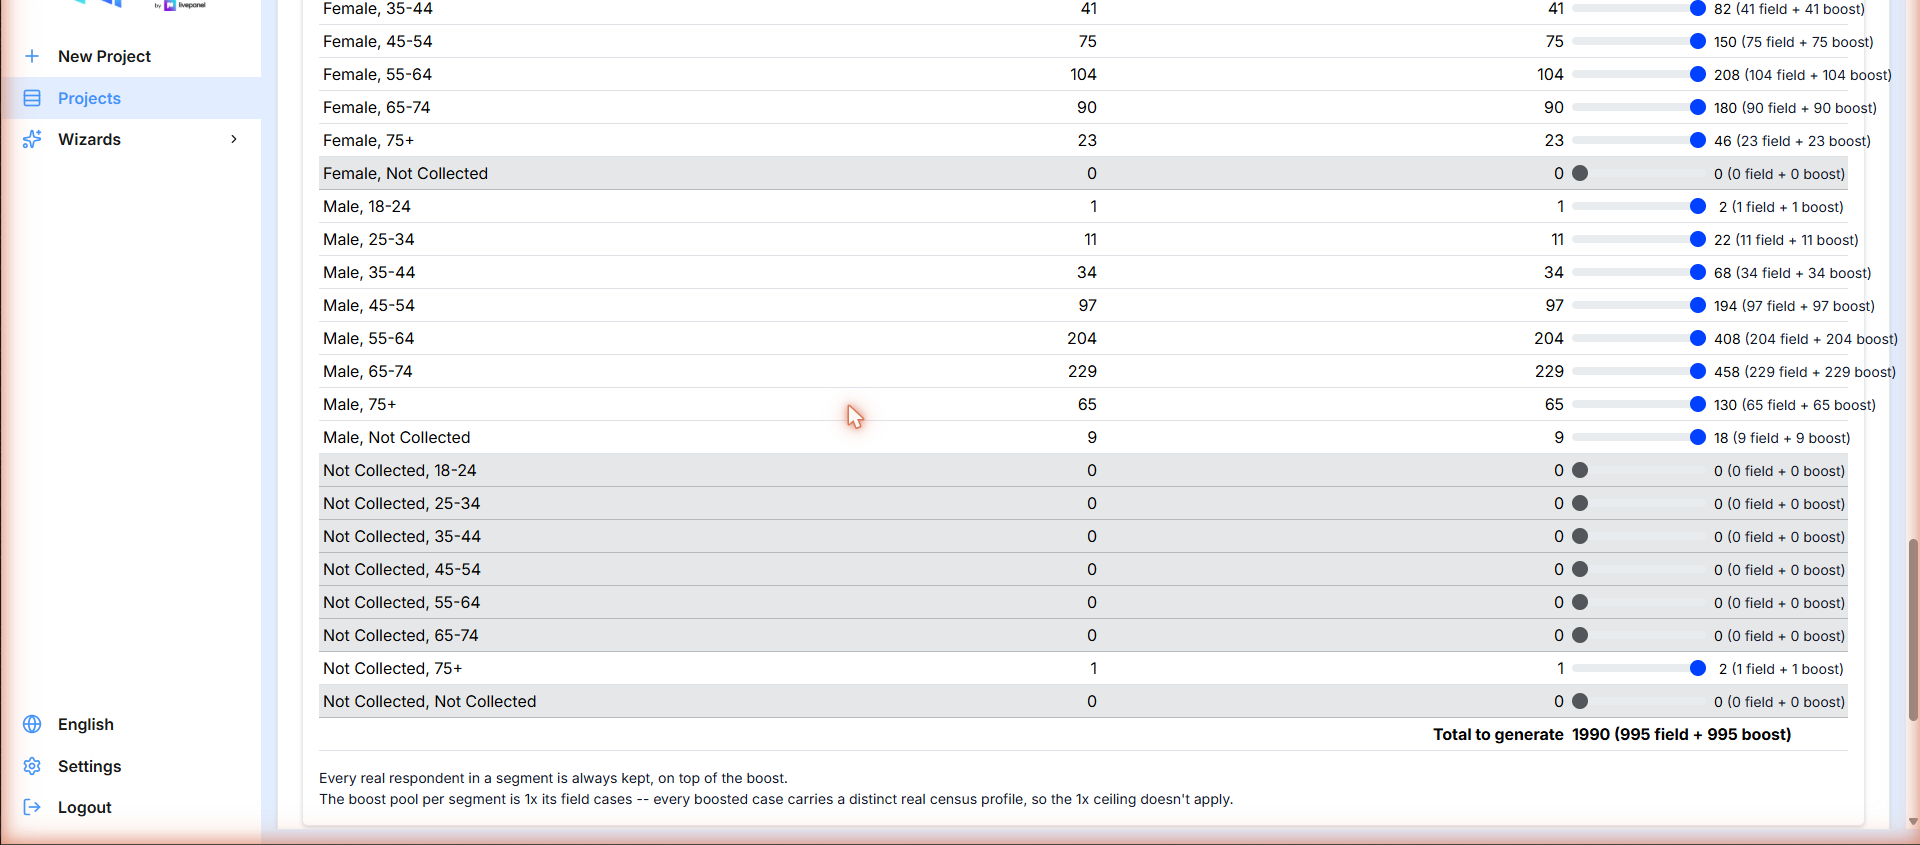
Cada encuestado real en un segmento siempre se mantiene, además del impulso. El grupo de impulso por segmento es N× sus casos de campo — cada caso impulsado lleva un perfil censal real distinto, por lo que el límite de 1× no se aplica.
En el modo de cuota objetivo, el pie de página se lee de manera diferente, porque no hay un límite que establecer: "The factor is derived from these targets on the server. Segments without enough real cases — including empty ones — are completed with census-based generated rows."
Balance options y SmartQuotas se comportan exactamente como en Swift. Finalice con Start Express processing, o Create without starting para dejar el proyecto en estado Created: